
一份踩坑后的工程清单。从选模型到调速度,每一步该做什么、容易踩什么坑,全列出来。
第一步:选模型 #
选模型不是"越大越好"。你需要考虑三个因素:
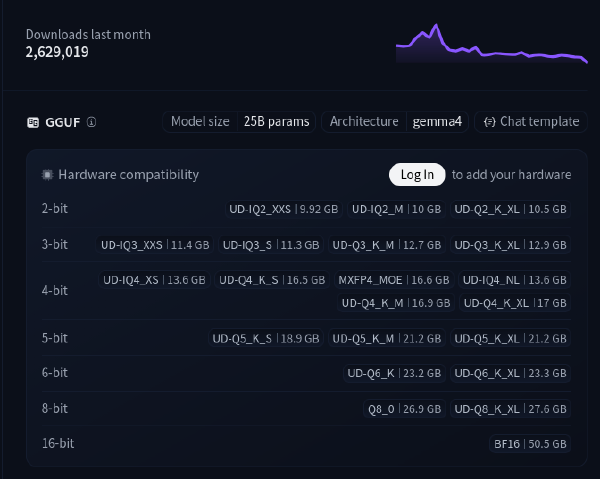
1. 参数量和你的显存
| 显存 | 能跑什么(Q4_K_M) | 推荐模型 |
|---|---|---|
| 6 GB | ~7B 密集 / 4B MoE | Qwen3.5-7B, Gemma4-E4B |
| 8 GB | 26B-35B MoE(3B 激活) | Qwen3.6-35B-A3B, MiMo-V2-flash, Gemma4-26B-A4B |
| 12 GB | 31B 密集 / MoE 更大余量 | Gemma4-31B, Qwen3.6-35B-A3B(余量大,64K 上下文随便开)Qwen3.6-27B-Dense |
| 24 GB | 109B MoE(17B 激活) |
2026 年本地模型的主力全是 MoE。Qwen3.6 总参 35B 但只激活 3B,这意味着 8GB 显存能跑"35B 级别"的模型,前提是你接受大部分 expert 走 CPU。
2. 模型家族的特性
2026 年本地部署的主力选手:
- Qwen 3.6:35B MoE(3B 激活),Apache 2.0,中文最强,本地首选。和 3.5 架构几乎一样但性能更好
- Gemma 4:Google 出品,有 26B MoE 和 31B Dense 两个版本,Apache 2.0,MTP 支持好
3. 从哪里下载
# 方法一:huggingface-cli(推荐)
huggingface-cli download Qwen/Qwen3.5-35B-A3B-GGUF \
    qwen3.5-35b-a3b-q4_k_m.gguf \
    --local-dir ./models

# 方法二:Ollama(最简单,一行命令)
ollama run qwen3.6:35b

# 方法三:直接 wget(需要知道确切 URL)
wget https://huggingface.co/Qwen/Qwen3.5-35B-A3B-GGUF/resolve/main/qwen3.5-35b-a3b-q4_k_m.gguf
第二步:选推理框架 #
| 框架 | 特点 | 适合谁 |
|---|---|---|
| llama.cpp | 底层引擎,参数最多,调优空间最大 | 想深入研究的人 |
| Ollama | 把 llama.cpp 包装成一行命令 | 大多数人的首选 |
| LM Studio | 图形界面,下载+对话一体化 | 不想碰命令行的人 |
| vLLM | 高吞吐服务端,纯 GPU | 有大显存的服务端部署 |
如果你只是想跑起来聊天,ollama run qwen2.5:8b 就够了。想调 MTP、MoE offload、TurboQuant 这些高级功能,再切到 llama.cpp。
第三步:配置 GPU offload #
这一步直接决定能不能跑起来、速度多快。
# -ngl 99:尽可能多的层放 GPU
# -ncmoe 24:MoE 模型专用,保留 24 个 expert 在 CPU
llama-server -m model.gguf -ngl 99 -ncmoe 24 -c 32768
-ncmoe 需要手动调
这个参数控制多少 MoE expert 放 CPU。值越大,GPU 占用越少,但 CPU↔GPU 传输开销也越大。没有万能值——从 16 开始试,每次加 4,找到速度拐点就停。
显存占用的来源:
模型权重(大头)    ← 量化精度决定
KV cache           ← 上下文长度决定
compute buffer     ← batch size 决定
MTP head           ← 额外约 80MB(可选)
第四步:设置上下文长度 #
-c 参数控制上下文窗口大小。越大能处理的文本越长,但显存占用也越大。
| 上下文长度 | KV cache 占用(估算) | 适用场景 |
|---|---|---|
| 4096 | ~0.3 GB | 短问答 |
| 8192 | ~0.6 GB | 普通聊天 |
| 32768 | ~2 GB | 长对话、角色扮演 |
| 65536 | ~4 GB | 长文档分析 |
KV cache 随上下文长度线性增长。32K 上下文大约占 2GB,64K 约 4GB。如果你的显存已经很紧张,不要设太大的上下文。
# 32K 上下文 + Flash Attention(省显存)
llama-server -m model.gguf -ngl 99 -c 32768 -fa on
Flash Attention (-fa on) 可以减少 KV cache 的显存占用,建议始终开启。
第五步:调速度 #
模型跑起来后,速度可能不理想。几个可以调的地方:
1. MTP(Multi-Token Prediction)
如果模型支持 MTP,这是最有效的加速手段:
llama-server -m model.gguf \
    --mtp-head mtp-head.gguf \
    --spec-type mtp \
--draft-block-size 3需要模型有对应的 MTP head 文件。Gemma 4 有官方 assistant MTP head,效果很好(实测 1.9x 提升)。不是所有模型都有。
2. batch size 和 ubatch size
-b 512 -ub 128    # 默认值,大多数场景够用
-b 2048 -ub 512   # 吞吐更高,但延迟也更大
3. 线程数
-t 16    # 推理线程数,通常设为 CPU 核心数
-tb 16   # batch 线程数
第六步:接入客户端 #
本地模型跑起来后,你需要一个界面来对话:
| 客户端 | 特点 | 适用场景 |
|---|---|---|
| SillyTavern | 角色扮演专用,功能最全 | 角色扮演、长期陪伴 |
| Open WebUI | Web 界面,类似 ChatGPT | 通用聊天 |
| Chatbox | 桌面应用,轻量 | 快速测试 |
| 自己写代码 | 直接调 API | 开发集成 |
容易踩的坑 #
1. 显存不够就 OOM
不是模型加载失败才叫 OOM——聊天到一半、上下文变长时也可能 OOM。留 0.5-1GB 显存余量。
2. 量化格式选错
Q4_K_M 在 GPU 上通常比 Q8_0 更快(因为带宽瓶颈)。但在 CPU 上可能相反。别只看文件大小。
3. 上下文设太大
32K 上下文看起来很爽,但 KV cache 会占 2GB 显存。如果你的模型已经把显存吃满了,上下文设大了直接 OOM。
4. 忘了设 -nocb
单人聊天时加 -nocb(关闭 continuous batching),可以减少显存占用和延迟。只有需要同时服务多个用户时才开 continuous batching。
5. MTP 速度会波动
MTP 的接受率受对话内容影响,同一配置不同对话可能差 5 t/s。测速时一定等回答完整结束再记录。