
下载本地模型时总会遇到 .gguf 文件。它不是"一种量化格式"那么简单——它是一个自包含的模型包,把权重、配置、词表全打包在一起,拿到任何机器上都能直接加载。
你下载的到底是什么 #
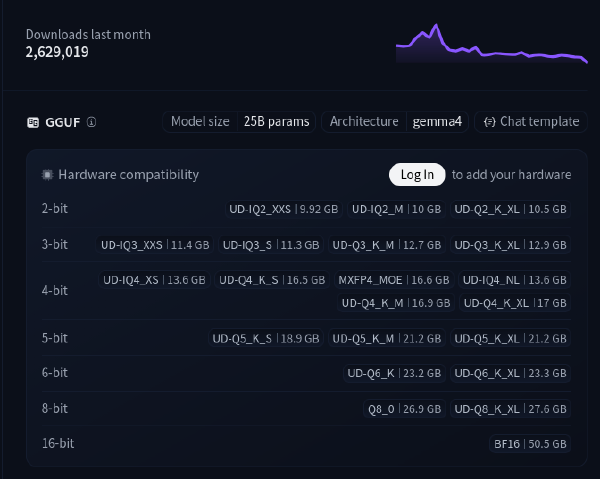
在 Hugging Face 上找模型,经常会看到同一个模型有多个文件:
gemma-4-26B-A4B-it-Q4_K_M.gguf    ← 这就是 GGUF
gemma-4-26B-A4B-it-Q5_K_M.gguf    ← 不同量化精度
gemma-4-26B-A4B-it-Q8_0.gguf      ← 更大,质量更好
这些 .gguf 文件,每一个都是完整的、自包含的模型包。你不需要额外下载配置文件、tokenizer、词表——全在里面了。
Hugging Face 上的原始模型通常是 safetensors 格式,配合一堆 JSON 配置文件。那是给 PyTorch/Transformers 用的。GGUF 是 llama.cpp 系列工具专用的格式,专门为 CPU/GPU 混合推理设计。两者不能混用——你不能把 safetensors 直接丢给 llama.cpp,也不能把 GGUF 丢给 Transformers。
一个 GGUF 文件里有什么 #
GGUF 的全称是 GPT-Generated Unified Format。它是一个二进制文件,内部结构大致是:
┌─────────────────────────┐
│  文件头(magic number)   │
├─────────────────────────┤
│  元数据(key-value pairs)│  ← 模型名称、架构、量化类型、
│                         │     词表大小、上下文长度……
├─────────────────────────┤
│  张量数据                │  ← 实际的模型权重,按层组织
│  (tensor data)          │     已经量化(Q4_K_M 等)
└─────────────────────────┘
元数据里存了什么?举几个例子:
| Key | 含义 | 示例值 |
|---|---|---|
general.architecture |
模型架构 | gemma3 |
general.name |
模型名称 | gemma-4-26B-A4B-it |
general.file_type |
量化类型 | Q4_K_M |
context.length |
最大上下文 | 131072 |
tokenizer.ggml.tokens |
词表 | [ "<pad>", "<eos>", ... ] |
你把一个 .gguf 文件拷到另一台机器上,只要有 llama.cpp(或 Ollama、LM Studio),就能直接加载。不需要联网下载任何东西。这对离线部署很重要。
为什么需要 GGUF #
原始模型(safetensors 格式)通常是 FP16 或 BF16 精度。一个 26B 参数的模型,FP16 存储需要约 52GB。你的显卡有 52GB 吗?没有。
GGUF 的核心价值是量化——把模型权重从高精度压缩到低精度:
| 精度 | 每个参数占多少字节 | 26B 模型大小 |
|---|---|---|
| FP16 | 2 字节 | 约 52 GB |
| Q8_0 | 1 字节 | 约 26 GB |
| Q4_K_M | 约 0.5 字节 | 约 14 GB |
| Q2_K | 约 0.25 字节 | 约 7 GB |
精度降低意味着质量损失。Q4_K_M 是目前公认的性价比甜点——大小砍半,质量损失大多数人感知不到。但 Q2_K 就比较明显了,尤其是长文本和复杂推理任务。后面会专门写一篇量化格式的详细解释。
怎么选 GGUF 文件 #
在 Hugging Face 上找到模型后,你通常会看到一堆 .gguf 文件。选哪个?
第一步:确定量化精度
- 日常聊天、角色扮演:Q4_K_M 足够
- 代码生成、复杂推理:Q5_K_M 或 Q6_K 更稳
- 显存非常紧张:Q3_K_M 是底线,再低质量掉太多
第二步:确认文件大小和你的显存
# 查看文件大小
ls -lh *.gguf

# 查看显存
nvidia-smiQ4_K_M 的文件大小(GB)≈ 你的显存上限。比如 8GB 显存,选 14GB 左右的 Q4_K_M 文件可以跑(靠 CPU offload 装剩下的部分),但选 26GB 的 Q8_0 就太勉强了。
第三步:检查是否有人做过 imatrix
有些 GGUF 文件名里带 imatrix,表示用 importance matrix 方法做的量化。这种量化在关键层保持更高精度,非关键层压得更低。质量通常比均匀量化好一点。
GGUF 的加载流程 #
当你用 llama.cpp 加载一个 GGUF 文件时,它做的事情大概是:
1. 读文件头,确认是 GGUF 格式
2. 读元数据,知道这是什么架构、多大的模型
3. 根据 -ngl 参数决定哪些层放 GPU、哪些放 CPU
4. 把张量数据映射到对应设备
5. 初始化 KV cache
6. 加载 tokenizer
7. 准备好,可以推理了
# 最简单的加载方式
./llama-cli -m model.gguf -p "Hello" -n 100
# 带 GPU offload
./llama-cli -m model.gguf -ngl 99 -p "Hello" -n 100-ngl 99 的意思是"尽可能多的层放 GPU"
99 不是真的放 99 层,而是"能放多少放多少"。如果模型太大,GPU 装不下所有层,剩下的自动走 CPU。
GGUF vs 其他格式 #
| 格式 | 谁用 | 特点 |
|---|---|---|
| GGUF | llama.cpp, Ollama, LM Studio | CPU/GPU 混合推理,自包含 |
| safetensors | PyTorch, Transformers | 训练/微调用,精度高 |
| GPTQ | GPU-only 推理 | 纯 GPU,4-bit,需要 CUDA |
| AWQ | GPU-only 推理 | 比 GPTQ 更快,但生态小一些 |
| EXL2 | ExLlamaV2 | 非常灵活的混合精度,但工具链小众 |
| MLX | MLX LM, Ollama (Mac) | Apple Silicon 专属,统一内存优化,Ollama 0.19+ 已支持 |
本地跑模型基本只用 GGUF。原因很简单:llama.cpp 生态最成熟,CPU/GPU 混合加载最灵活,而且 Ollama、LM Studio、SillyTavern 全都支持。其他格式要么需要纯 GPU(显存不够),要么工具链太小众。
实际体验 #
下载一个 GGUF 文件,你大概会经历这个流程:
# 1. 从 Hugging Face 下载
huggingface-cli download bartowski/gemma-4-26B-A4B-it-GGUF \
    gemma-4-26B-A4B-it-Q4_K_M.gguf \
    --local-dir ./models

# 2. 加载并对话
./llama-cli -m ./models/gemma-4-26B-A4B-it-Q4_K_M.gguf \
    -ngl 99 -c 4096 \
    -p "你好,请介绍一下自己" -n 512

# 3. 或者起一个 API 服务
./llama-server -m ./models/gemma-4-26B-A4B-it-Q4_K_M.gguf \
    -ngl 99 -c 32768 \
    --host 127.0.0.1 --port 8080
就这么简单。一个文件,一条命令,本地大模型就跑起来了。