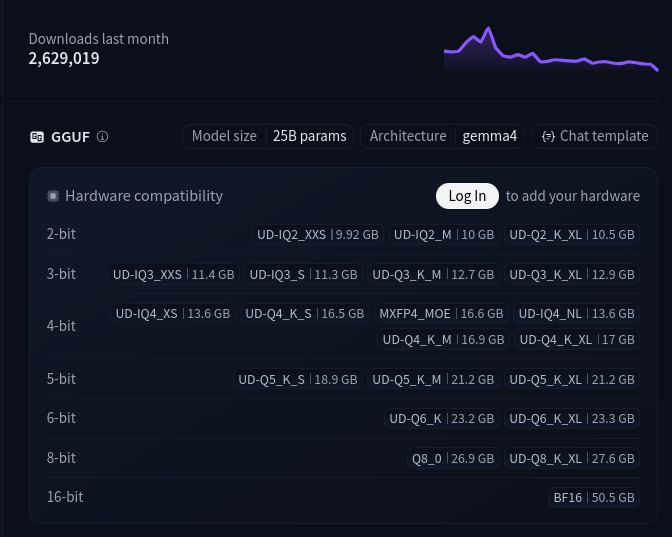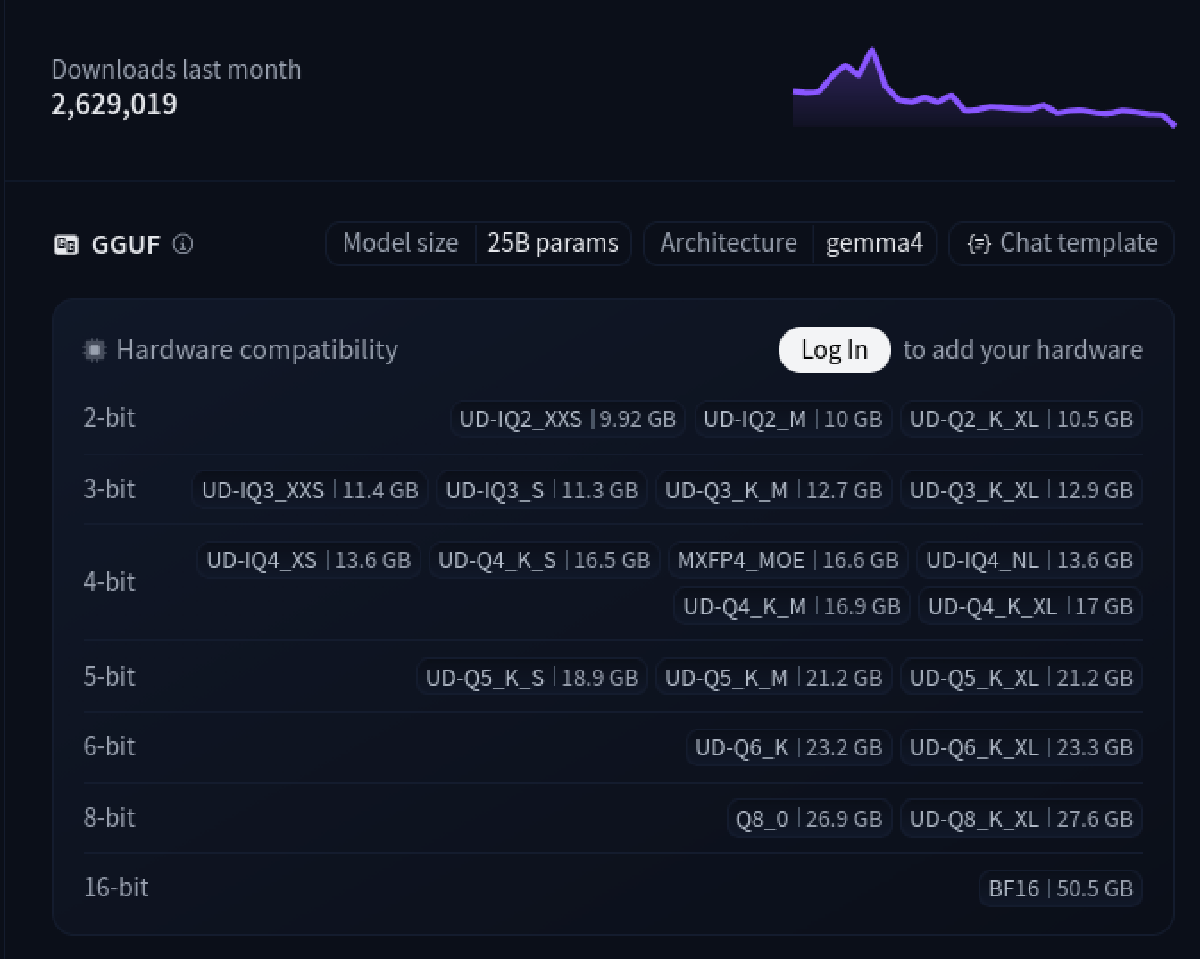

Q4_K_M 里的每个字母都有含义。Q=量化位数,K=K-quant 方法,M=Medium 变体。选错了不只是质量差——还可能更慢。
这些后缀到底什么意思 #
在 Hugging Face 上下载 GGUF 模型,文件名通常是这样的:
gemma-4-26B-A4B-it-Q4_K_M.gguf
                      ├─┤├─┤├┤
                      │  │  └─ Medium(变体大小)
                      │  └──── K-quant(量化方法)
                      └─────── 4-bit(目标精度)
拆开看:
- Q4:目标是 4-bit 量化,每个权重用约 4 bit 存储
- K:使用 K-quant 方法(也叫 k-quants),不是简单的均匀量化
- M:Medium 变体。同一个精度有 S(Small)、M(Medium)、L(Large)三档,M 是最常用的
| 后缀 | 含义 | 适用场景 |
|---|---|---|
| Q2_K | 2-bit,最激进 | 显存极限,质量有明显损失 |
| Q3_K_M | 3-bit medium | 显存紧张的底线选择 |
| Q4_K_M | 4-bit medium | 性价比甜点 |
| Q5_K_M | 5-bit medium | 质量更好,显存多 30% |
| Q6_K | 6-bit | 接近 Q8,但更小 |
| Q8_0 | 8-bit | 几乎无损,但体积翻倍 |
K-quant 是什么 #
早期的量化方法是"均匀量化"——所有层、所有参数用同样的精度。比如 Q4_0 就是每个权重都用 4 bit。
K-quant 的思路不同:关键层用更高精度,不重要的层压更低。具体来说:
- Attention 层(Q、K、V 投影)保持较高精度
- FFN 层可以压得更狠
- 第一层和最后一层通常不量化(或用很高精度)
这就像 JPEG 压缩——对人眼敏感的区域保留更多细节,不敏感的区域大力压缩。
同样是 4-bit,Q4_0 和 Q4_K_M 的质量差距很明显。K-quant 版本在 perplexity(困惑度,衡量模型质量的指标)上通常好 0.5-1.0 个点。听起来不多,但对长文本生成和复杂推理的影响是能感知到的。
量化怎么影响速度 #
这里有个反直觉的事实:量化精度越低,不一定越快。
原因在于量化格式的计算方式:
Q4_K_M:
  - 权重用 4-bit 存储
  - 推理时需要反量化到 FP16 再计算
  - 反量化有开销,但内存带宽需求更低

Q8_0:
  - 权重用 8-bit 存储
  - 反量化开销更小
  - 但内存带宽需求更高
在 GPU 推理中,瓶颈通常是显存带宽。Q4_K_M 比 Q8_0 小一半,意味着每秒能加载更多权重,所以通常更快。
但在 CPU 推理中,计算能力才是瓶颈。Q4_K_M 需要更多反量化计算,可能比 Q8_0 慢。
在 GPU 上,Q4_K_M 通常比 Q8_0 快 30-50%。但在 CPU 上,Q4_0 可能比 Q4_K_M 慢,因为 K-quant 的非均匀量化在某些 CPU 指令集上反而更高效。建议实测,别只看文件大小。
imatrix 量化是什么 #
有些文件名里带 imatrix:
gemma-4-26B-A4B-it-Q4_K_M-imatrix.ggufimatrix(importance matrix)是一种更智能的量化方法。它先用一批校准数据跑一遍模型,统计每层每个权重的重要性。然后:
- 重要性高的权重 → 保持更高精度
- 重要性低的权重 → 压得更狠
结果是同样 4-bit,imatrix 版本的质量通常比标准版好一点,尤其是对模型的知识保留和推理能力。
如果同一个模型有 imatrix 版本,优先选它。大小差不多,质量更好。没有 imatrix 版本就用标准的 K-quant,差距不大。
实际建议 #
- 默认选 Q4_K_M——性价比最高,8GB 显存也能跑 26B 模型
- 显存充足就上 Q5_K_M——质量更好,但别指望能跑更大模型
- Q3_K_M 是底线——再低质量掉太多,不如换个小模型
- 有 imatrix 版本就用 imatrix
- CPU 推理选 Q8_0——带宽不是瓶颈时,高精度更好