
8GB 显存的笔记本显卡,跑 26B 参数模型,生成速度从 13 t/s 干到 27.5 t/s。靠的是 Gemma 4 官方 assistant MTP。
为什么要折腾本地模型 #
说实话,云端大模型在代码生成和强推理上确实强。但有些场景它替代不了——私有笔记问答、角色扮演、长期陪伴、纯离线使用。这些需求共同点是:你不想把数据发出去。
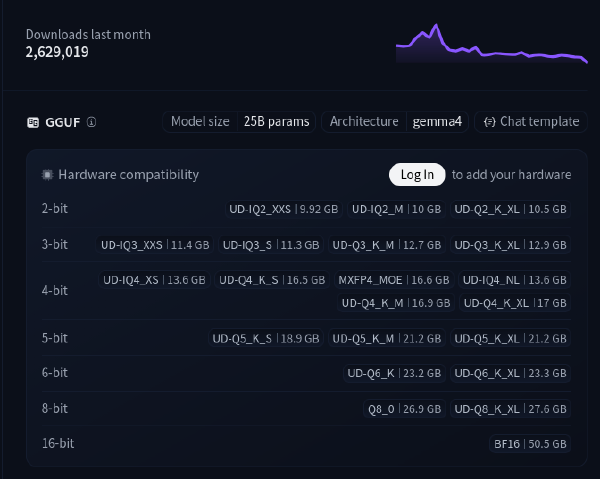
问题是,26B 参数的模型,Q4_K_M 量化后权重还有 16GB 左右。RTX 4060 Laptop 只有 8GB 显存,装不下。所以第一个问题很明确:怎么在 8GB 显存上跑 16GB 的模型?
CPU: Ryzen 9 7940H
GPU: RTX 4060 Laptop 8GB
RAM: 32GB
OS: Ubuntu 22.04
NVIDIA Driver: 570.211.01
CUDA Toolkit: 12.8
第一步:MoE 混合加载 #
Gemma 4 26B 是 MoE(Mixture of Experts)架构——模型有很多 expert,但每次推理只激活其中一部分。这意味着可以把大部分 expert 丢到 CPU/RAM 上,只把频繁激活的层放 GPU。
llama.cpp 的 -ngl 控制放多少层到 GPU,-ncmoe 控制保留多少 expert 在 CPU。我最终用的参数:
-ngl 99 -ncmoe 24-ncmoe 不是越大越好
试过更大的值,显存没占满不代表更快。MoE offload 的瓶颈是 CPU↔GPU 带宽和调度开销,不是显存容量。24 是我测出来的甜点区。
这一步把 mainline llama.cpp 的速度从 13 t/s 提到了约 14.5 t/s。有改善,但体感还是不够流畅。
第二步:普通 draft model 翻车 #
Speculative decoding 的思路是:用一个小模型(draft model)快速生成草稿 tokens,大模型一次性验证。如果草稿命中率高,整体速度就上去了。
我试了 E2B 小模型做 draft。结果:
- draft 全放 GPU:显存不够,两个模型挤在一起,反而更慢
- draft 放 CPU:CPU 推理太慢,草稿生成的开销吃掉了验证的收益
这条路走不通。
第三步:Gemma 4 assistant MTP 逆转 #
事情的转机发生在谷歌官方发布了 Gemma 4 官方 assistant MTP ——专门为 Gemma 4 架构设计的 MTP(Multi-Token Prediction)头。它和主模型共享结构,显存开销极小(约 80MB),但能一次预测多个 token。
llama-server \
    -m supergemma4-26b-uncensored-fast-v2-Q4_K_M.gguf \
    --mtp-head gemma-4-26B-A4B-it-assistant.Q4_K_M.gguf \
    --spec-type mtp \
    --draft-block-size 3 \
    -ngl 99 -ngld 99 -ncmoe 24 \
    -t 16 -tb 16 \
    -b 512 -ub 128 \
    -c 32768 -n 2048 \
    -fa on -np 1 -nocb \
    --reasoning off \
    --host 127.0.0.1 --port 8080
结果:
| 配置 | 上下文 | 显存 | 生成速度 |
|---|---|---|---|
| mainline llama.cpp,无 MTP | 32K + 2048 | 6.14 GiB | 13 t/s |
| Atomic fork baseline,无 MTP | 32K | 5.58 GiB | 14.51 t/s |
| Atomic fork + Gemma assistant MTP | 32K + 2048 | 6.26 GiB | 27.5 t/s |
14.51 → 27.5 t/s,接近 1.9 倍。显存只多了 80MB。
mainline llama.cpp 当时对 Gemma 4 assistant MTP 的支持还不完整。Atomic fork(atomic-llama-cpp-turboquant)有更好的 MTP 路径和调度优化。后续主线合并了部分支持(截至写这篇文章时,主线llama.cpp只支持Qwen MTP),但 AT fork 在这个场景下仍然更强。
draft-block-size 扫参 #
MTP 有一个 draft-block-size 参数,控制每轮草稿预测几个 token。理论上越大越快,但实际不是:
| draft-block-size | 生成速度 | 备注 |
|---|---|---|
| 2 | 22.9 t/s | 稳定 |
| 3 | 22.9–27.5 t/s | 甜点区 |
| 4 | 17.5 t/s | 明显变慢 |
block-size 越大,草稿越长,但接受率会下降。一旦验证失败,浪费的计算反而更多。在 4060 8GB 上,3 是当前最稳的选择。
TurboQuant KV:省显存还是省速度? #
TurboQuant 是 AT fork 的另一个特性,可以压缩 KV cache。我测了 32K 上下文下的表现:
| 模式 | 显存 | Prefill | Decode | 质量 |
|---|---|---|---|---|
| base(不压缩) | 6.55 GiB | 412 tok/s | 19.5 t/s | 正常 |
| tq4 | 5.98 GiB | 418 tok/s | 16.67 t/s | 正常 |
| tq3 | 5.91 GiB | 421 tok/s | 17.56 t/s | 正常 |
| tq2 | 5.88 GiB | 423 tok/s | 15.89 t/s | 正常 |
省了约 0.6GB 显存,但生成速度反而降了。所以日常用 base KV 就行,只有显存紧张时才切 tq3。
我的策略:
日常聊天:base KV
长上下文或显存紧张:tq3
对照实验:Qwen3.6 MTP #
除了 Gemma 4,我还测了 Qwen3.6 的 MTP 支持。结论很直接——能跑,但收益有限。
| 配置 | 显存 | 生成速度 | 相对提升 |
|---|---|---|---|
| Qwen3.6 mainline,无 MTP | 7.07 GiB | 8.39 t/s | baseline |
| Qwen3.6 mainline + MTP | — | 12.37 t/s | +47% |
| Qwen3.6 AT fork + NextN | 7.81 GiB | 14 t/s | +67% |
| Qwen3.6 AT fork + MTP + TQ3 | 6.82 GiB | 9.6 t/s | +14% |
对比 Gemma 4:
Gemma 4 MTP:14.51 → 27.5 t/s,约 1.9x
Qwen3.6 MTP:8.39 → 14 t/s,约 1.67x(AT fork 最优)Qwen3.6 35B 也是 MoE,但它的 expert 激活模式和 Gemma 4 不同。在 8GB 显存上,更多权重需要走 CPU/RAM 路径,baseline 就低。MTP 收益虽然存在(+47%~67%),但绝对速度还是追不上 Gemma 4。Qwen3.6 在 12GB 以上显存可能表现更好,但在我的 4060 上,Gemma 4 assistant MTP 是更实际的选择。
踩坑记录 #
1. 普通 draft model 在 8GB 上不可用
之前试过 E2B 小模型做 draft,全放 GPU 显存不够,放 CPU 太慢。这条路在 8GB 显存上基本走不通。真正有效的是 Gemma 4 官方 assistant MTP 这种专用 drafter——它和主模型共享结构,显存开销几乎可以忽略。
2. MoE offload 需要手动调参
-ncmoe 的甜点区因硬件而异。我在 4060 上测出来 24 最好,但换个显卡可能完全不同。建议从 40 开始往下试,每次减 2,找到速度拐点就停。
3. MTP 速度会波动
MTP 的接受率受输出内容、上下文长度影响,同一配置不同对话的速度可能差 5 t/s。测速时一定等回答完整结束再记录,中途看数值会飘。
最终配置 #
后端:Atomic fork(atomic-llama-cpp-turboquant)
主模型:gemma4-26B-A4B-uncensored-Q4_K_M.gguf
MTP head:gemma-4-26B-A4B-it-assistant.Q4_K_M.gguf
KV 模式:base(日常) / tq3(显存紧张)
上下文:32K(可到 64K)
输出长度:4096
生成速度:20–29 t/s(视对话内容波动)
显存占用:6.26 GiB
结论 #
- 8GB 显存能跑 26B 模型,前提是 MoE 架构 + CPU/GPU 混合加载
- 普通 speculative decoding 在 8GB 上不可行,但专用 MTP head 完全不同
- Gemma 4 assistant MTP 是目前最有效的本地加速方案,接近 1.9x 提升,显存几乎不增加
- TurboQuant 是省显存的工具,不是加速器,日常不需要开