
🌟 欢迎来到第10讲:卷积码 (Convolutional Codes)——带记忆的编码与图形化描述 #
(对应教材《数字通信原理》第八章 8.8 节)
在之前的课程中,我们学习的编码方式,无论是简单的重复码还是复杂的循环码,都有一个共同点:它们都是分组码。就像一位工匠,独立地将每一块原料(信息组)加工成一个成品(码字),加工下一个时就完全忘记了上一个。
今天,我们要学习一种全新的、更强大的编码哲学——卷积码。
- ✨ 生动的比喻:有短期记忆的流水线
- 分组码:一个工匠,一次只处理一个订单,订单之间互不相干。
- 卷积码:一条智能流水线。当它处理当前的零件时,不仅会根据这个零件的规格进行操作,还会参考刚刚经过的几个零件的状态。这种"短期记忆"使得它的加工过程更连贯、更精妙。
卷积码的这种"记忆"特性,使得当前时刻的编码输出不仅与当前输入有关,还与过去几个时刻的输入有关。这让它在处理连续的数据流时表现极其出色。为了驾驭这种带记忆的编码,我们将引入一套全新的图形化分析工具:状态图、树图和网格图,它们是理解卷积码译码算法(尤其是大名鼎鼎的维特比算法)的钥匙。
学习目标:
- 理解卷积码与分组码的根本区别——“记忆”。
- 掌握卷积码的核心参数 $(n, k, L)$ 及其物理意义。
- 能够根据编码器电路,写出其输入输出关系,并能手动模拟编码过程。
- 学会用数学工具(生成矩阵、生成多项式)来描述卷积码。
- 【核心】 熟练掌握描述卷积码动态行为的三种图形工具:状态图、树图、网格图。
- 理解卷积码的距离衡量标准——自由距离,及其在网格图上的意义。
📝 本讲主要内容 #
1. 什么是卷积码?——引入"记忆"的编码 #
1.1. 与分组码的核心区别 (PPT p4) #
| 特性 | 分组码 | 卷积码 |
|---|---|---|
| 记忆性 | 无记忆 | 有记忆 |
| 编码关系 | 第 $i$ 组的 $n$ 位输出,仅与第 $i$ 组的 $k$ 位输入有关。 | 第 $i$ 组的 $n$ 位输出,与第 $i$ 组、第 $i-1$ 组、…、第 $i-L+1$ 组的输入都有关。 |
| 数据处理 | 将信息分块,块与块之间独立编码。 | 将信息视为连续的流,连续进行编码。 |
1.2. 编码器结构与核心参数 $(n,k,L)$ (PPT p5) #
卷积码编码器由 $k$ 个移位寄存器组和 $n$ 个模2加法器(线性逻辑)构成。
【图片:PPT p5 的通用卷积码编码器结构图】
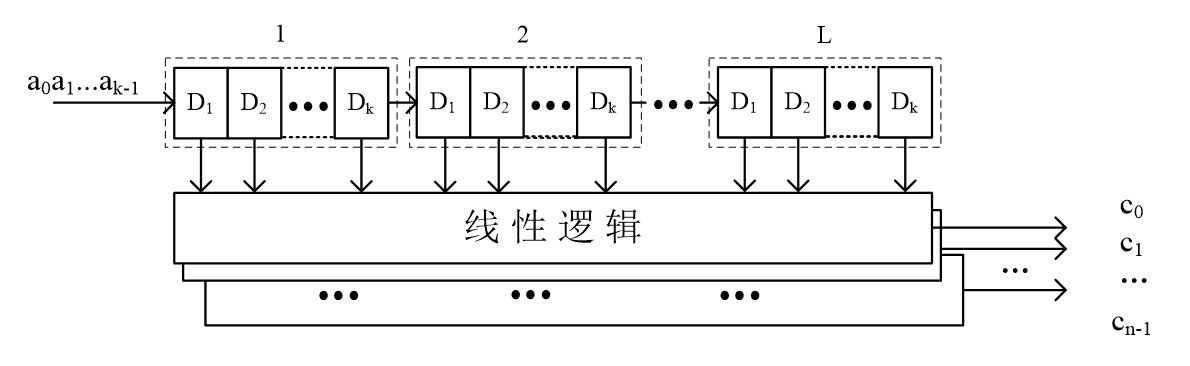
- 参数定义:
- $k$: 每个时刻,输入到编码器的信息比特数。
- $n$: 每个时刻,编码器输出的码元比特数。
- $L$: 约束长度 (Constraint Length)。这是一个非常关键的参数,它定义了编码器的"记忆深度"。具体指,当前输入的一个信息码组,能够影响未来连续 $L$ 个输出码组。
- 编码效率 (码率): 依然是 $R = k/n$。
2. 描述卷积码:从电路到数学,再到图形 #
我们将以一个贯穿始终的 $(3,1,3)$ 卷积码为例来学习。
2.1. 编码器电路与输入输出关系 (PPT p6) #
-
参数: (n=3, k=1, L=3)。
- 每个时刻输入1比特,输出3比特。
- 当前输入会影响未来3个输出码组。
-
电路图: 【图片:PPT p6 的(3,1,3)卷积码编码器电路图】
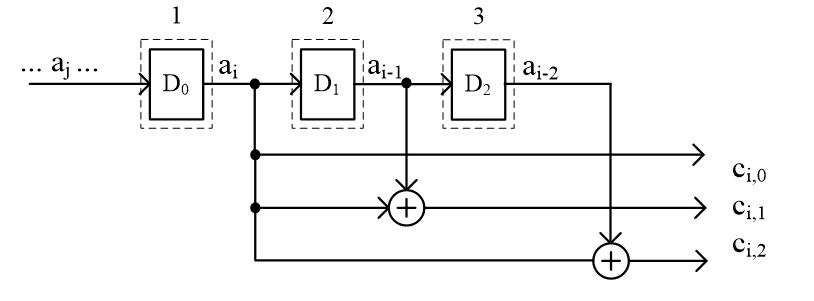
-
输入输出关系: 设 $a\_i$ 是 $i$ 时刻的输入比特,$a\_{i-1}, a\_{i-2}$ 是存储在寄存器中的前两个时刻的输入。 $$ \begin{cases} c_{i,0} = a_i \\ c_{i,1} = a_i \oplus a_{i-1} \\ c_{i,2} = a_i \oplus a_{i-2} \end{cases} $$
-
状态: 编码器在 $i$ 时刻的状态,由移位寄存器中存储的内容决定。在本例中,状态就是 $(a\_{i-1}, a\_{i-2})$。
-
编码过程示例 (PPT p7):
- 输入序列: $1011...$ (假设编码器初始状态为00)
- t=0: 输入 $a\_0=1$。状态 $(a\_{-1}, a\_{-2})=(0,0)$。
- 输出: $c\_{0,0}=1$, $c\_{0,1}=1\oplus0=1$, $c\_{0,2}=1\oplus0=1$。输出 $111$。
- 新状态: $(a\_0, a\_{-1})=(1,0)$。
- t=1: 输入 $a\_1=0$。状态 $(a\_0, a\_{-1})=(1,0)$。
- 输出: $c\_{1,0}=0$, $c\_{1,1}=0\oplus1=1$, $c\_{1,2}=0\oplus0=0$。输出 $010$。
- 新状态: $(a\_1, a\_0)=(0,1)$。
- t=2: 输入 $a\_2=1$。状态 $(a\_1, a\_0)=(0,1)$。
- 输出: $c\_{2,0}=1$, $c\_{2,1}=1\oplus0=1$, $c\_{2,2}=1\oplus1=0$。输出 $110$。
- … 以此类推,最终输出序列为 $111; 010; 110; 101; ...$
2.2. 数学描述 #
- 卷积关系 (PPT p8-9): 编码器的每个输出序列,都可以看作是输入序列与该输出通路单位脉冲响应的卷积。
- 单位脉冲响应: 当输入为 $1000...$ 时,编码器三个输出端各自产生的序列。
- 第0个输出 (c_0): $100...$
- 第1个输出 (c_1): $110...$
- 第2个输出 (c_2): $101...$
- 单位脉冲响应: 当输入为 $1000...$ 时,编码器三个输出端各自产生的序列。
- 生成多项式 (PPT p13): 将每个单位脉冲响应序列表示为多项式。 $$ g^{(0)}(X) = 1 \\ \space \space \space g^{(1)}(X) = 1+X \\ \space \space \space g^{(2)}(X) = 1+X^2 $$ 这些多项式构成了生成多项式矩阵: $G(X) = [1, \ 1+X, \ 1+X^2]$。
- 生成矩阵 G (PPT p11-12): 对于连续输入的卷积码,其生成矩阵是一个无限延伸的带状矩阵,由单位脉冲响应的码组 $G\_i$ 构成,不便于使用,故多项式表示更为常用。
2.3. 图形化描述:让编码过程"看得见" #
这是理解卷积码,特别是其译码算法(如维特比算法)的关键。我们将以一个 $(2,1,3)$ 码为例。
- 状态图 (State Diagram) (PPT p42-43)
- ✨ 生动的比喻: 一张城市的"地铁图"。
- 站点 (Nodes): 编码器所有可能的状态。对于 (2,1,3) 码,约束长度L=3,k=1,状态由 $k(L-1)=2$ 个比特决定,共 $2^2=4$ 个状态: 00, 01, 10, 11。
- 线路 (Edges): 状态之间的转移路径。
- 票价/信息 (Labels): 每条线路上标注 $输入 / 输出$。例如从状态$10$出发,如果输入$1$,会转移到状态$11$,并输出码组$01$,这条线路就标注为 $1/01$。
- 优点: 简洁地展示了所有状态转移关系。
- 缺点: 看不到时间演进的过程。
- 树图 (Tree Diagram) (PPT p45)
- ✨ 生动的比喻: 一个不断生长的家族树。
- 从一个根节点(初始状态)开始,每个时刻根据可能的输入($k$比特,这里是0或1)产生新的分支。
- 优点: 清晰地展示了从初始时刻开始,随时间演进,所有可能的编码路径。
- 缺点: 树的规模随时间指数增长,很快就会变得庞大无比,不实用。
- 网格图 (Trellis Diagram) (PPT p46-47)
- ✨ 生动的比喻: 一张铺开的、有规律的"渔网"。它是状态图和树图的完美结合。
- 结构:
- 横轴: 时间 $t$。
- 纵轴: 在每个时间点 $t$,列出所有可能的状态。
- 连线: 连接 $t$ 时刻和 $t+1$ 时刻状态的线,表示一次状态转移。
- 核心思想: 树图之所以会无限发散,是因为它没有考虑状态是会重复出现的。网格图将所有到达相同状态的路径合并到同一个节点上。
- 优点:
- 结构规整,不会随时间无限膨胀。
- 清晰地展示了从任意状态到任意状态的所有可能路径。
- 任何一条从左到右贯穿网格图的路径,都唯一地对应一个合法的编码输出序列。
- 编码过程: 给定一个输入序列,就是在网格图上走出一条唯一的路径。例如输入$1011...$,就是从$00$状态走$1$对应的分支,再走$0$对应的分支… (PPT p49)。
3. 卷积码的性能与问题 #
3.1. 距离特性:自由距离 d_free (PPT p51) #
- 定义: 卷积码的"码字"是整个输出序列。自由距离是指,任意两个不同的编码输出序列之间,汉明距离的最小值。
- 与网格图的关系: 由于卷积码是线性的,$d\_free$ 等于所有离开全零路径,并最终返回全零路径的路径中,其码重(路径上所有输出码组的汉明重量之和)的最小值。
- ✨ 生动的比喻: 在"渔网"图上,有一条笔直的"全零高速公路"。自由距离就是,你从这条高速公路上任意一个出口下去,“野游"一圈后,再从某个入口回到高速公路,这条"野游"路径上所产生的最小的非零输出码重。
- $d\_free$ 越大,卷积码的纠错能力越强,它扮演了类似分组码中 $d\_min$ 的角色。
3.2. 潜在风险:灾难性传播 (Catastrophic Error Propagation) (PPT p57-59) #
- 现象: 在某些设计不佳的卷积码中,信道中有限个比特的错误(例如1、2个错误),可能导致译码器在后续输出无限长的错误信息比特。
- ✨ 生动的比喻: 多米诺骨牌效应。推倒了一个,后面倒下一大片。
- 原因: 编码器存在一个输入序列,它包含无穷多个$0$,但产生的输出码重却是有限的。这意味着译码器可能会把一个非全零的序列误判为全零序列,导致后续解码全部出错。
- 避免方法 (定理 8.8.1): 对于 $(n,1,L)$ 码,要成为非恶性码,其所有生成多项式 $g^{(0)}(X), g^{(1)}(X), \dots, g^{(n-1)}(X)$ 的最大公因式 (GCD) 必须是 $X^l$ 的形式($l \ge 0$)。
- 重要推论: 对于系统码,由于至少有一个生成多项式是 $1$,所以它们的 GCD 永远是 $1$,因此系统卷积码一定是非恶性码。
