
🌟 欢迎来到第5讲:信道编码基础与香农第二定理 #
(对应教材《数字通信原理》第四章 4.6 节及第八章)
想象一下,你在一个非常嘈杂的派对上,想告诉远处的朋友一个重要的电话号码。直接喊过去,对方很可能听错几个数字。你会怎么做?你可能会放慢语速、提高音量,甚至重复几遍:“号码是’五(伍)-八(捌)-三(叁)’,重复一遍,大写的伍、捌、叁!” 你刚刚所做的,就是信道编码的朴素版本——通过增加冗余(放慢语速、重复、使用更明确的词)来对抗信道中的噪声(派对的嘈杂声)。
本讲,我们将系统地学习信道编码的理论基础,并最终触及信息论的另一座丰碑——香农第二定理(信道编码定理)。它将告诉我们一个颠覆直觉的惊人事实:只要信息传输速率在一个特定极限(信道容量)之下,我们就能找到一种编码方式,实现无限接近于零错误的完美通信!
学习目标:
- 理解信道编码的基本模型和核心概率概念(先验、后验、转移概率)。
- 掌握两种最佳译码准则:最大后验概率 (MAP) 和最大似然 (ML) 译码。
- 深刻理解信道编码定理的物理意义及其对现代通信的指导作用。
📚 本讲知识地图 #
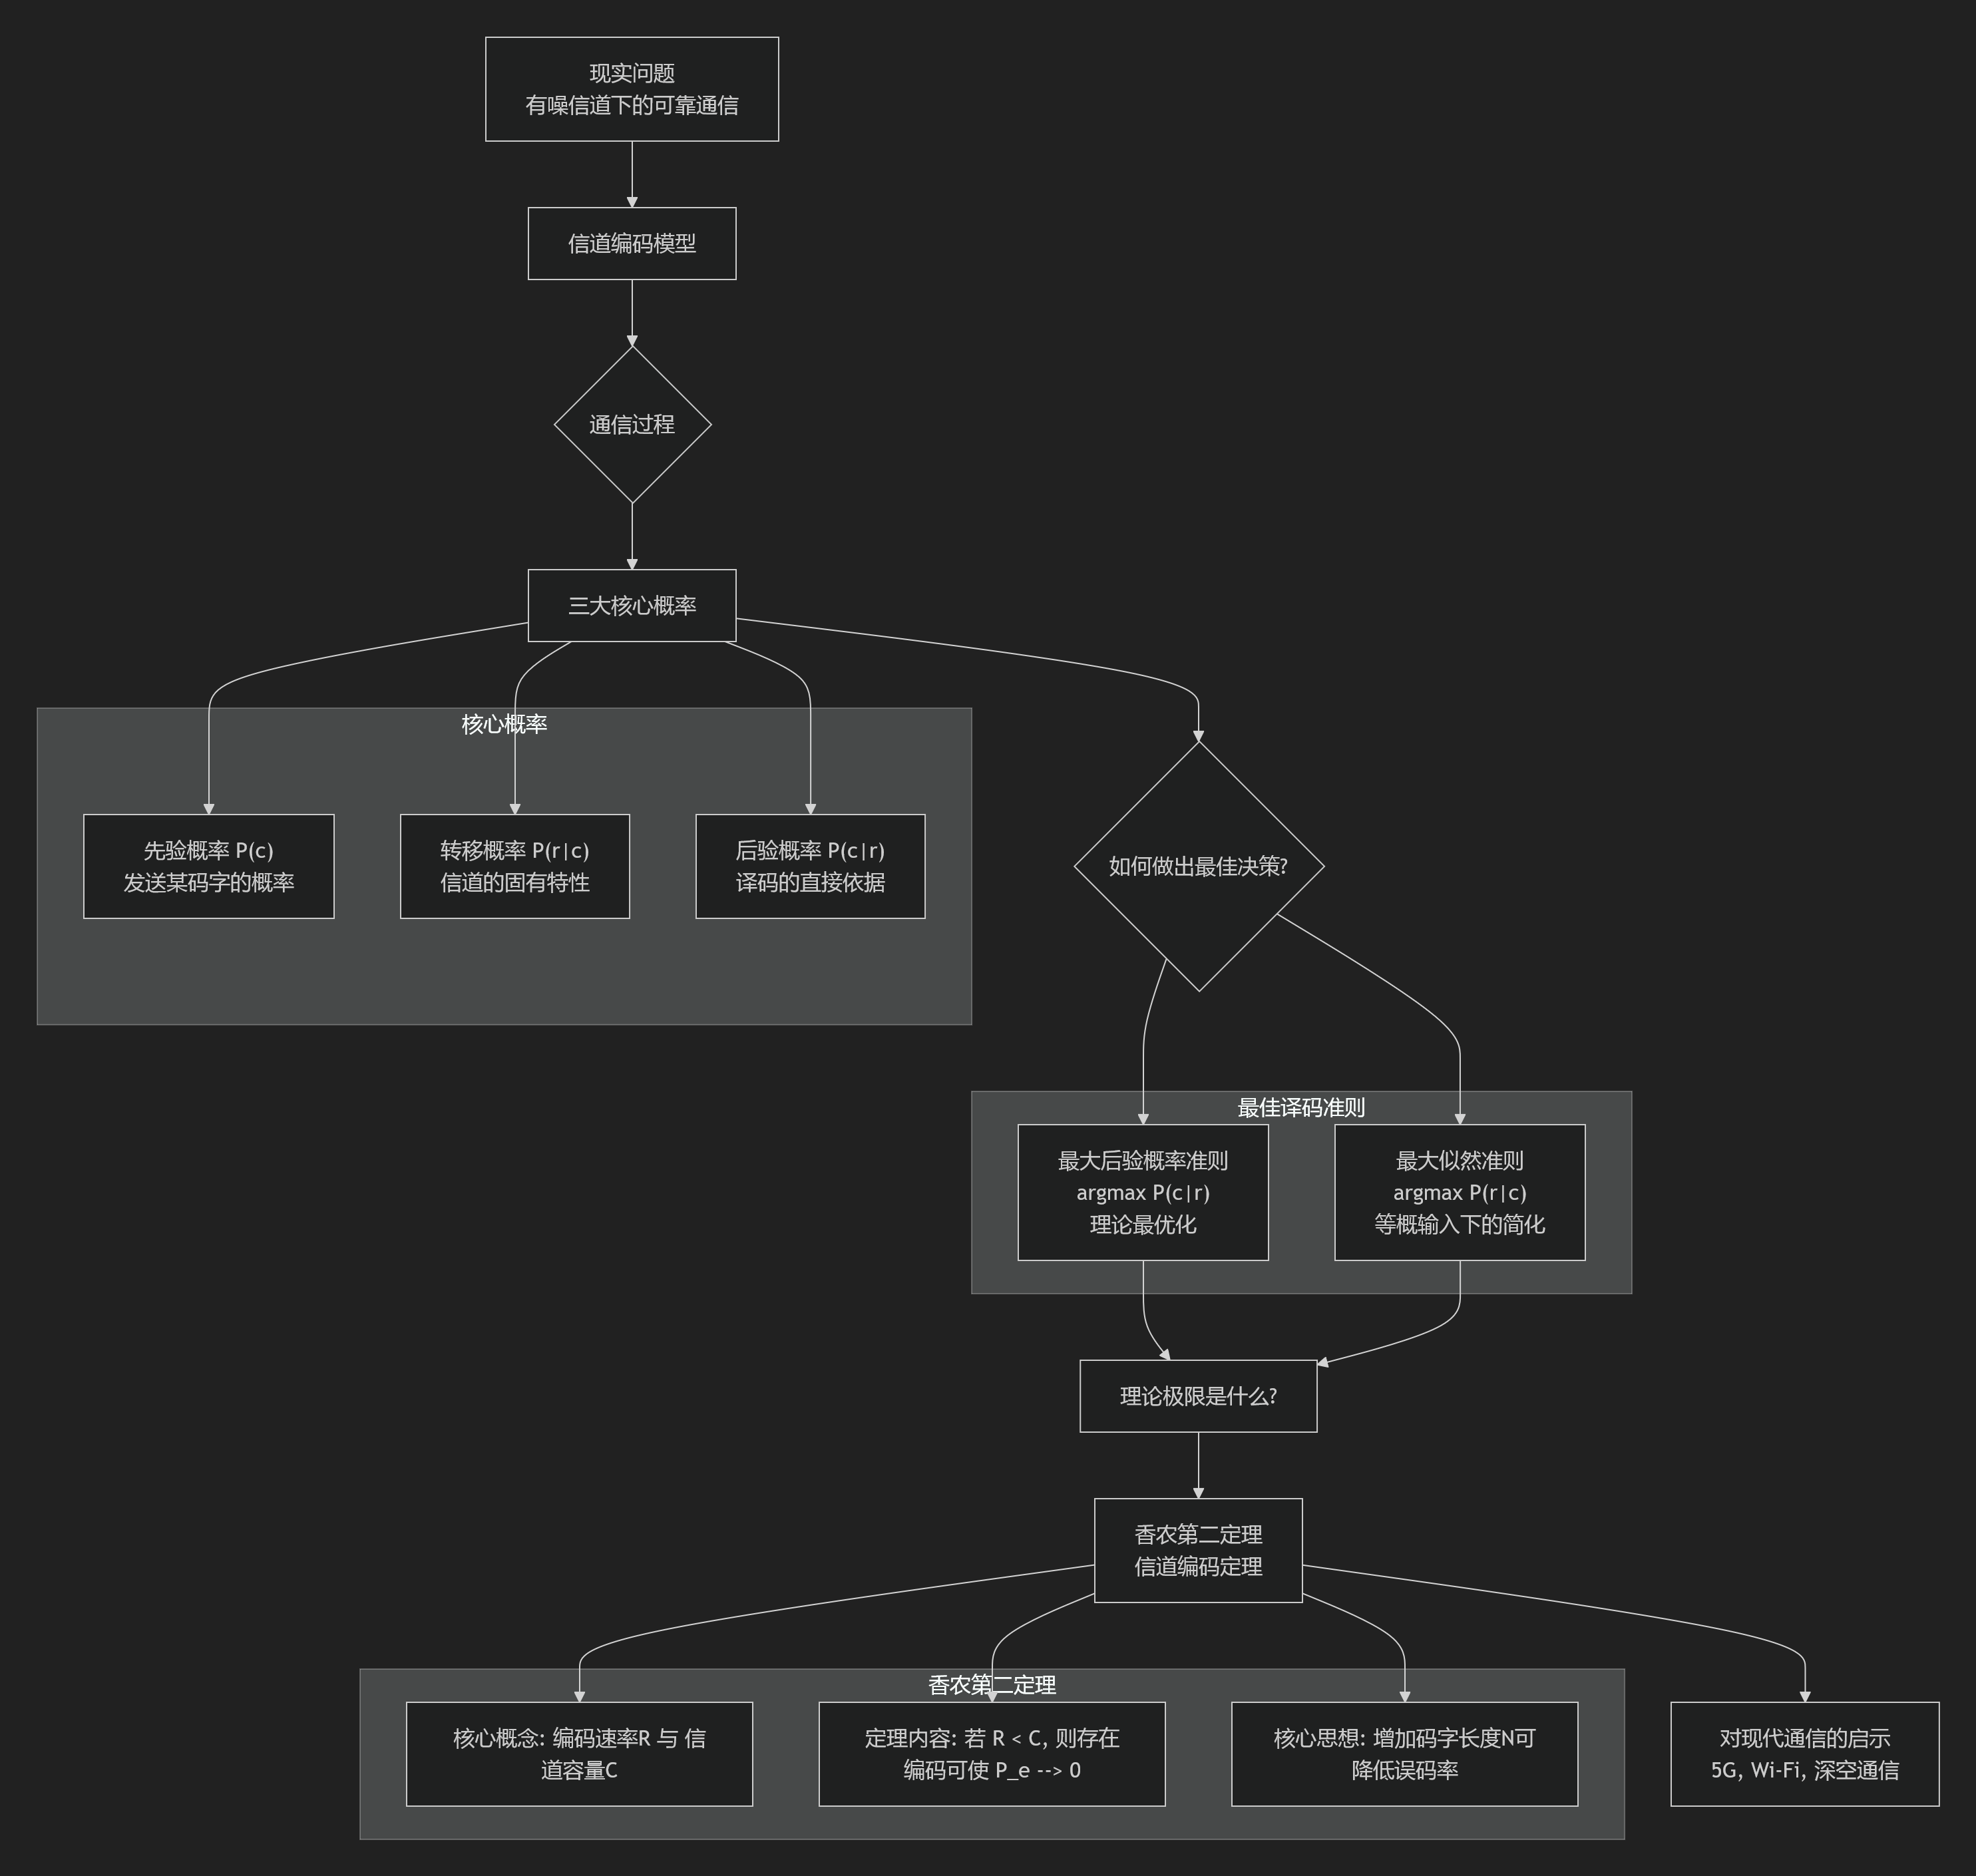
📝 本讲主要内容 #
1. 编码通信系统模型与关键概率 #
为了科学地对抗噪声,我们首先要建立一个数学模型。
1.1. 基本模型 #
一个包含信道编码的通信系统可以简化为以下流程:
【图片:PPT p3 的编码信道基本模型图】
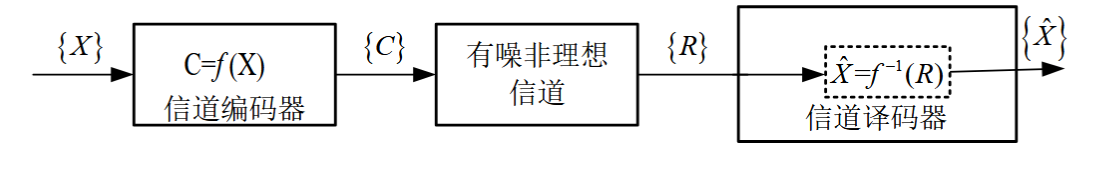
- 信源符号集 {X}: 原始信息,如
(0, 1)。 - 信道编码器 C=f(X): 接收信源符号,按照特定规则(编码)映射成更长的码字,形成发送码字集 {C}。例如,将
0映为000,1映为111。这个过程主动地加入了冗余。 - 有噪信道: 码字在传输中受到干扰,可能发生错误。例如
000可能变成了010。 - 接收码字集 {R}: 接收端收到的可能已出错的码字序列。
- 信道译码器 X̂ = f⁻¹(R): 根据收到的
R和已知的编码规则,尽最大努力猜测原始的信源符号X,得到 译码输出 {X̂}。
1.2. 三种核心概率:理解译码的钥匙 #
译码的本质就是一个基于概率的"猜谜游戏"。要玩好这个游戏,必须理解三种概率:
| 概率类型 | 符号 | 含义与解释 |
|---|---|---|
| 先验概率 (Prior) | $P(c\_i)$ | 在接收到任何信息之前,我们就知道发送端发送码字 $c\_i$ 的概率。它只与信源和编码器的特性有关。 |
| 转移概率 (Transition) | $P(r\_j\|c\_i)$ | 在发送码字 $c\_i$ 的条件下,接收到码字 $r\_j$ 的概率。这完全由信道的物理特性决定,描述了信道"搞破坏"的能力。 |
| 后验概率 (Posterior) | $P(c\_i\|r\_j)$ | 译码的核心! 在我们已经接收到码字 $r\_j$ 的条件下,反推当初发送的码字是 $c\_i$ 的概率。 |
- ✨ 生动的比喻:医生诊断病情
- 先验概率 $P(c\_i)$: 医生知道,在这个季节,“流感 (
c_1)” 的发病率很高,而"罕见病 (c_2)“的发病率很低。这是医生的先验知识。 - 转移概率 $P(r\_j\|c\_i)$: 医生知道,“流感 (
c_1)” 有 90% 的概率会导致“发烧 (r_j)“这个症状;而"罕见病 (c_2)” 只有 10% 的概率导致"发烧 (r_j)"。这是疾病的固有特性。 - 后验概率 $P(c\_i\|r\_j)$: 现在,一个病人来了,他确实在发烧 (
r_j)。医生需要综合以上所有信息,来判断他到底是得了"流感 (c_1)” 还是"罕见病 (c_2)” 的概率。这个诊断结果就是后验概率。
- 先验概率 $P(c\_i)$: 医生知道,在这个季节,“流感 (
- 🔧 核心数学表示 (PPT p3-4):
- 发送码字的先验概率: 一个行向量,代表了发送端码字集的统计分布。 $$ P(C) = [p(c_1), p(c_2), \dots, p(c_M)] $$
- 信道转移概率矩阵: 这是描述信道本身特性的核心。矩阵的每一行代表一个发送码字,每一列代表一个接收码字。 $$ [P(R|C)] = \begin{bmatrix} p(r_1|c_1) & p(r_2|c_1) & \cdots & p(r_N|c_1) \\ p(r_1|c_2) & p(r_2|c_2) & \cdots & p(r_N|c_2) \\ \vdots & \vdots & \ddots & \vdots \\ p(r_1|c_M) & p(r_2|c_M) & \cdots & p(r_N|c_M) \end{bmatrix} $$
- 后验概率矩阵: 这是我们译码决策的最终依据。矩阵的每一行代表一个接收码字,每一列代表一个发送码字。 $$ [P(C|R)] = \begin{bmatrix} p(c_1|r_1) & p(c_2|r_1) & \cdots & p(c_M|r_1) \\ p(c_1|r_2) & p(c_2|r_2) & \cdots & p(c_M|r_2) \\ \vdots & \vdots & \ddots & \vdots \\ p(c_1|r_N) & p(c_2|r_N) & \cdots & p(c_M|r_N) \end{bmatrix} $$ 后验概率通过贝叶斯公式计算:$P(c\_i|r\_j) = \frac{P(r\_j|c\_i)P(c\_i)}{P(r\_j)}$,其中 $P(r\_j) = \sum\_{i=1}^{M} P(c\_i)P(r\_j|c\_i)$。
2. 译码的艺术:如何做出最佳猜测? #
从 PPT p5-6 的例子可以看出,对于同一个信道和信源,不同的译码规则会导致天差地别的错误率。我们的目标是找到那个能让平均错误概率 $P\_E$ 最小的译码规则。 #### 2.1. 【实例剖析】译码规则如何致命地影响系统性能 (PPT p5-6) 让我们来看一个具体的例子,直观感受一下译码规则的重要性。
- 问题设定:
- 发送码字集 C = {0, 1},且等概发送,即 $p(c\_1=0)=p(c\_2=1)=0.5$。
- 接收码字集 R = {0, 1}。
- 我们有两个不同的二进制对称信道 (BSC):
| 信道 | 转移概率矩阵 $[P(RC)]$ | 信道特性解读 |
|---|---|---|
| 信道1 | $$ \begin{bmatrix} 0.8 & 0.2 \\ 0.2 & 0.8 \end{bmatrix} $$ | 这是一个"正常"信道,接收与发送符号相同的概率 (0.8) 远大于出错的概率 (0.2)。 |
| 信道2 | $$ \begin{bmatrix} 0.2 & 0.8 \\ 0.8 & 0.2 \end{bmatrix} $$ | 这是一个"反转"信道,接收与发送符号相反的概率 (0.8) 远大于相同的概率 (0.2)。 |
-
四种可能的译码规则:
- 规则(1) D(0)=0, D(1)=0:无论收到什么,都译码成 0。
- 规则(2) D(0)=0, D(1)=1:收 0 译 0,收 1 译 1 (直观规则)。
- 规则(3) D(0)=1, D(1)=0:收 0 译 1,收 1 译 0 (反向规则)。
- 规则(4) D(0)=1, D(1)=1:无论收到什么,都译码成 1。
-
错误率计算与分析: 错误概率 $P\_E = p(\text{发} 0, \text{译} 1) + p(\text{发} 1, \text{译} 0)$
对于信道1 (\[0.8, 0.2; 0.2, 0.8\]):
- 规则(2) $P\_E = p(0)p(1|0) + p(1)p(0|1) = 0.5 \times 0.2 + 0.5 \times 0.2 = \textbf{0.2}$
- 规则(3) $P\_E = p(0)p(0|0) + p(1)p(1|1) = 0.5 \times 0.8 + 0.5 \times 0.8 = 0.8$
- 结论: 对于"正常"信道1,最直观的规则(2)错误率最低。
对于信道2 (\[0.2, 0.8; 0.8, 0.2\]):
- 规则(2) $P\_E = p(0)p(1|0) + p(1)p(0|1) = 0.5 \times 0.8 + 0.5 \times 0.8 = 0.8$
- 规则(3) $P\_E = p(0)p(0|0) + p(1)p(1|1) = 0.5 \times 0.2 + 0.5 \times 0.2 = \textbf{0.2}$
- 结论: 对于"反转"信道2,反向的规则(3)错误率最低。
-
💡 深刻启示:
- 没有普适的"最佳"规则:最佳译码规则与信道特性强相关。
- 盲目猜测不可取:需要一种科学的方法来系统性地找到最佳译码规则,而不是逐一尝试。
2.2. 最大后验概率 (MAP) 译码准则 #
MAP 准则是理论上最完美的译码准则。它的思想非常直观:
$$ \hat{c} = D(r_j) = \underset{c_i \in \{C\}}{\operatorname{argmax}} P(c_i|r_j) $$当接收到码字 $r\_j$ 后,计算所有可能的发送码字 $c\_i$ 的后验概率 $P(c\_i\|r\_j)$,然后选择那个后验概率最大的作为译码结果 $\hat{c}$。
- 工程意义: MAP 准则充分利用了我们掌握的所有信息——包括信源的统计特性(通过 $P(c\_i)$ 体现)和信道的特性(通过 $P(r\_j\|c\_i)$ 体现),来做出最符合逻辑的猜测。它能保证在所有译码准则中,平均错误概率 $P\_E$ 最小。
2.2.1 【实例应用】用MAP准则解决上述问题 (PPT p8) #
让我们用MAP准则,看看它是否能自动帮我们找到最佳规则。 由于 $p(c\_1)=p(c\_2)=0.5$ 且信道对称,可以算出 $p(r\_1)=p(r\_2)=0.5$。
- 对于信道1:
- 后验概率矩阵 $[P(C|R)] = \begin{bmatrix} P(c\_1|r\_1) & P(c\_2|r\_1) \\\ P(c\_1|r\_2) & P(c\_2|r\_2) \end{bmatrix} = \begin{bmatrix} 0.8 & 0.2 \\\ 0.2 & 0.8 \end{bmatrix}$
- 决策:
- 收到 $r\_1=0$ 时,比较 $P(c\_1=0|r\_1=0)=0.8$ 和 $P(c\_2=1|r\_1=0)=0.2$,选择 $c\_1=0$。故 $D(0)=0$。
- 收到 $r\_2=1$ 时,比较 $P(c\_1=0|r\_2=1)=0.2$ 和 $P(c\_2=1|r\_2=1)=0.8$,选择 $c\_2=1$。故 $D(1)=1$。
- 结果: MAP准则给出的译码规则是 {D(0)=0, D(1)=1},正是我们之前暴力尝试找到的最佳规则(2)!
- 对于信道2:
- 后验概率矩阵 $[P(C|R)] = \begin{bmatrix} 0.2 & 0.8 \\\ 0.8 & 0.2 \end{bmatrix}$
- 决策:
- 收到 $r\_1=0$ 时,比较 $P(c\_1=0|r\_1=0)=0.2$ 和 $P(c\_2=1|r\_1=0)=0.8$,选择 $c\_2=1$。故 $D(0)=1$。
- 收到 $r\_2=1$ 时,比较 $P(c\_1=0|r\_2=1)=0.8$ 和 $P(c\_2=1|r\_2=1)=0.2$,选择 $c\_1=0$。故 $D(1)=0$。
- 结果: MAP准则给出的译码规则是 {D(0)=1, D(1)=0},正是最佳规则(3)!
- 💡 结论: 看,我们不再需要盲目地尝试所有规则。MAP准则就像一个精确的导航系统,直接带我们找到了通往最低错误率的路径。
2.3. 最大似然 (ML) 译码准则 #
MAP 准则虽好,但计算后验概率 $P(c\_i\|r\_j)$ 有时比较复杂。在通信工程中,有一个非常常见的简化场景:发送的码字是等概率的,即 $P(c\_1) = P(c\_2) = ... = P(c\_M)$。在这种情况下,MAP 准则可以简化为 ML 准则。
根据贝叶斯公式 $P(c\_i|r\_j) = \frac{P(r\_j|c\_i)P(c\_i)}{P(r\_j)}$,如果 $P(c\_i)$ 都相等,$P(r\_j)$ 对所有 $c\_i$ 也是常数,那么最大化 $P(c\_i\|r\_j)$ 就等价于最大化 $P(r\_j\|c\_i)$。
$$ \hat{c} = D(r_j) = \underset{c_i \in \{C\}}{\operatorname{argmax}} P(r_j|c_i) $$当接收到码字 $r\_j$ 后,我们问这样一个问题:“哪个发送码字 $c\_i$ 最有可能产生我们观测到的 $r\_j$?” 我们选择那个使转移概率 (似然函数) $P(r\_j\|c\_i)$ 最大的 $c\_i$ 作为译码结果。
- 工程意义: ML 译码实现更简单,因为它只需要知道信道的特性 $P(r\_j\|c\_i)$,而不需要知道信源的统计信息。在许多系统中,信源已经被信源编码器"平坦化",使得输出的符号近似等概,因此 ML 准则应用非常广泛。
3. 香农第二定理:可靠通信的基石 #
我们现在知道了如何进行单次最佳译码。但香农走得更远,他问了一个终极问题:我们对抗噪声的能力有没有一个极限?我们能否做到完美通信?
3.1. 核心概念 #
- (信道)编码速率 $R\_t$: 衡量编码效率的指标。
$$
R_t = \frac{K}{N}
$$
其中,$K$ 是信息位的长度,$N$ 是编码后码字的总长度。例如,将 2 比特信息 (
K=2) 编成 4 比特码字 (N=4),则速率为 $R\_t = 2/4 = 0.5$。速率越低,冗余度越高。 - 信道容量 C: 描述了一个信道无差错传输信息的能力上限。它是一个仅由信道转移概率 $P(r\_j\|c\_i)$ 决定的常数,单位是比特/信道使用。
3.2. 定理 4.6.2 (信道编码定理) #
对于一个给定的离散无记忆信道,其信道容量为 $C$。
- 若信息传输速率 $R < C$,那么一定存在一种编码方法,当码长 $N$ 足够长时,可以使译码的错误概率 $P\_E$ 任意小 ($P\_E \to 0$)。
- 若信息传输速率 $R > C$,那么不可能找到任何一种编码方法,使得译码错误概率任意小。
- ✨ 费曼学习法之生动比喻:信息高速公路
- 信道:一条高速公路。
- 噪声:公路上的各种干扰,如拥堵、事故、恶劣天气。
- 信道容量 C:这条高速公路的法定最高时速(例如 120 km/h)。这个速度是公路本身设计决定的,与你开什么车无关。
- 编码速率 R:你的实际行车速度。
- 香农定理说:
- 只要你的车速
R低于最高限速C(例如你开 110 km/h),即使路上有很多干扰,你也总能找到一种足够"聪明"的驾驶策略(一个足够好的编码方案),让你安全、无刮蹭地到达目的地。你开得越"聪明"(码长 N 越长),就越安全($P\_E$ 越小)。 - 如果你试图超速行驶(
R > C),那么无论你的车技多么高超(无论用什么编码),发生事故(错误)都是不可避免的。
- 只要你的车速
3.3. 两个重要启示 #
- 可靠通信是可能的,但有速率上限:香农定理第一次从理论上宣告,与噪声的斗争是可以胜利的!但这胜利有个前提:你的信息传输率不能超过信道的"物理极限"——信道容量 C。
- 增加码长是王道:定理证明的关键在于"当码长 N 足够长时"。这意味着,为了获得更低的误码率,我们应该设计更长的码字(例如 PPT p22 的例子,
N=6的编码优于N=4的编码)。这是现代纠错码(如 Turbo 码、LDPC 码)设计的基本思想——通过处理很长的数据块来实现逼近香农极限的性能。
4. 理论照进现实:信道编码如何降低错误率? #
香农定理说增加码长 N 可以降低误码率。让我们通过实例来验证这个思想。
4.1. 简单但强大的思想:重复编码 (PPT p11) #
- 场景: 某个BSC信道,出错概率 $P\_E=0.01$。
- 无编码: 直接发送
0或1,错误率就是 0.01。 - 3次重复编码:
- 发送
0时,实际发送000。 - 发送
1时,实际发送111。 - 译码规则: 采用"少数服从多数"的原则。例如收到
001,010,100,000都译为0。
- 发送
- 新的错误率: 译码出错,当且仅当3个比特中出错2个或3个。 $$ P_E' = \underbrace{C_3^2 p^2(1-p)}_{\text{错2个}} + \underbrace{C_3^3 p^3(1-p)^0}_{\text{错3个}} = 3 \times (0.01)^2 \times 0.99 + (0.01)^3 \approx 3 \times 10^{-4} $$
- 效果: 错误率从 $10^{-2}$ 骤降至 $3 \times 10^{-4}$,性能提升了约33倍!代价是传输速率降为原来的1/3。
4.2. 保持速率,增加码长 (PPT p21-22) #
更进一步,我们可以在保持编码速率不变的情况下,通过设计更长的码来提升性能。
-
场景: BSC信道,比特错误率 $p=0.1$。编码速率固定为 $R\_t=0.5$。
-
方案一: (4,2) 编码 (K=2, N=4)
- 编码规则见PPT p21表格。
- 该编码能纠正1位错误。
- 正确译码的概率 Q = (不出错的概率) + (只错1位的概率) $$ Q = (1-p)^4 + C_4^1 p (1-p)^3 = (0.9)^4 + 4 \times 0.1 \times (0.9)^3 = 0.6561 + 0.2916 = 0.9477 $$
- 码字错误率 $P\_{E,word} = 1 - Q = 1 - 0.9477 = 0.0523$。
- 等效到信息位的错误率 $p\_1$。可以近似认为信息位正确传输的概率为 $\sqrt{Q}$ (因为两位信息都正确),则 $1-p\_1 = \sqrt{0.9477} \approx 0.9735$,所以 $p\_1 \approx 0.0265$。(注:此为PPT简化估算,实际计算更复杂,但趋势正确)。错误率从 0.1 降低到约 0.0265。
-
方案二: (6,3) 编码 (K=3, N=6)
- 编码速率 $R\_t=3/6=0.5$,与方案一相同。
- 该编码也能纠正1位错误。
- 正确译码的概率 Q’ = (不出错的概率) + (只错1位的概率) $$ Q' = (1-p)^6 + C_6^1 p (1-p)^5 = (0.9)^6 + 6 \times 0.1 \times (0.9)^5 = 0.5314 + 0.3543 = 0.8857 $$
- 码字错误率 $P\_{E,word}' = 1-Q' = 0.1143$
- 等效信息位错误率 $p\_2$。$1-p\_2 = \sqrt{Q'} = \sqrt{0.8857} \approx 0.9605$,所以 $p\_2 \approx 0.0395$。
-
💡 实例结论:
- 增加冗余有效:两种方案都显著降低了等效信息位的错误率。
- 码长是关键:在相同编码速率下,使用更长的码字(方案二N=6 vs 方案一N=4),能够获得更强的纠错能力,进一步降低错误率。(注:PPT中提供的例子和计算有些简化,但其旨在说明的"在相同码率下,增加码长可以提升性能"这一核心思想是完全正确的,这也是现代编码(如Turbo/LDPC码)的基础。)
🔗 知识关联与应用 #
- 承上启下:
- 与率失真理论的结合:现在我们可以把信息论的两大基石放在一起了。一个完整的通信系统目标是:先用信源编码(如上一讲的率失真理论)将信源压缩到信息率 $R\_s$,然后再用信道编码(本讲内容)将其在信道上传输。整个系统能可靠工作的条件是:压缩后的信息率必须小于信道容量,即 $R\_s < C$。
- 为纠错码学习铺路:香农定理是一个"存在性"定理,它只告诉我们"足够好的码是存在的",但没告诉我们具体怎么构造。后续的课程,如线性分组码、循环码、卷积码等,就是工程师们为了寻找并实现香农所预言的"好码"而发展出的各种具体技术。
- 现实应用:
- 5G/Wi-Fi 通信:你手机信号时好时坏,但通话和上网却很少出错,这背后是强大的信道编码(如 LDPC 码和 Polar 码)在默默工作。它们会根据信道质量动态调整编码速率 R,尽量逼近信道容量 C,从而在保证可靠性的前提下最大化你的网速。
- 深空探测:旅行者号探测器距离地球数百亿公里,信号极其微弱,信道条件极差。它能将木星、土星的清晰照片传回地球,靠的就是精心设计的级联信道编码,将错误概率降到了极低的水平。
- 二维码 (QR Code):你有没有发现,即使二维码有些污损或遮挡,手机常常也能扫出来?这是因为二维码内部包含了里德-所罗门 (Reed-Solomon) 纠错码,它允许在一定程度的"信道噪声"(污损)下,仍然能 100% 恢复出原始信息。
🤔 引导式提问 #
- 为什么在实际系统中,ML 译码比 MAP 译码更常用?这背后体现了通信系统设计中怎样的分层思想? (提示:信源编码和信道编码的分离)
- 香农定理告诉我们,可以通过增加码长 N 来让错误概率 $P\_E$ 趋近于 0。那为什么在现实世界中(比如 Wi-Fi),我们不把码长 N 设计得无限长,从而实现绝对无误的通信呢? (提示:思考延迟和计算复杂度)
- 给你一条信道,其容量为 $C = 0.8$ 比特/符号。现在有一个信源,其熵 $H(X) = 0.9$ 比特/符号。你是否能通过这条信道无差错地传输这个信源?如果不能,结合上一讲的知识,你需要怎么做才能传输它?
💡 本讲总结 #
本讲我们踏入了对抗噪声的领域——信道编码。我们建立了编码通信系统的基本模型,并掌握了进行最佳译码的两种核心武器:MAP 准则(理论最优)和 ML 准则(工程常用)。更重要的是,我们学习了香农第二定理,它如同一座灯塔,为所有通信系统的设计指明了方向:信道容量 C 是可靠通信的速率天花板。只要我们的信息速率 R 小于 C,通过设计足够长、足够精妙的编码,我们就能在噪声的惊涛骇浪中,开辟出一条风平浪静的完美通信航路。
🔍 相关缩写 #
| 缩写 | 全称 | 中文含义 |
|---|---|---|
| MAP | Maximum a Posteriori Probability | 最大后验概率 |
| ML | Maximum Likelihood | 最大似然 |
