
🌟 欢迎来到第9讲:循环码——优雅的代数结构与高效的电路实现 #
(对应教材《数字通信原理》第八章8.6)
在上节,我们学习了用矩阵来"生产"和"检验"码字。今天,我们要给这个过程装上"流水线"。循环码就是这样一种自带"流水线"属性的编码。它的核心特点是循环移位不变性:一个合法的码字,把它像传送带一样循环挪动任意位,得到的仍然是一个合法的码字!
这种看似简单的特性背后,蕴含着深刻的代数结构。它允许我们抛开繁琐的矩阵,转而使用一个更强大的工具——多项式——来描述和操作码字。编码过程将变为多项式乘法,而译码和校验则变为多项式除法求余数。最精彩的是,这一切都可以用简单的线性反馈移位寄存器 (LFSR) 电路来飞速完成。本讲,我们将彻底揭开循环码的面纱,从多项式表示到最终的电路实现。
学习目标:
- 【语言】 掌握用多项式描述码字,并熟练进行模2下的多项式加、乘、除运算。
- 【理论】 深刻理解生成多项式 g(X) 的核心地位及其代数性质(是 $X^n+1$ 的因式,能整除所有码多项式)。
- 【编码】 彻底掌握系统型循环码的编码原理,能手算多项式长除法求得监督位,并能根据 g(X) 画出编码器电路。
- 【译码】 理解伴随式多项式 S(X) 的原理,并掌握利用其循环特性进行错误定位的精髓。
- 【硬件】 能够分析译码器电路,并完整复现一个码字的接收、校验、错误定位和纠正的全过程。
- 【扩展】 了解循环汉明码和强大的BCH码的设计思想与能力。
📚 本讲知识地图 #
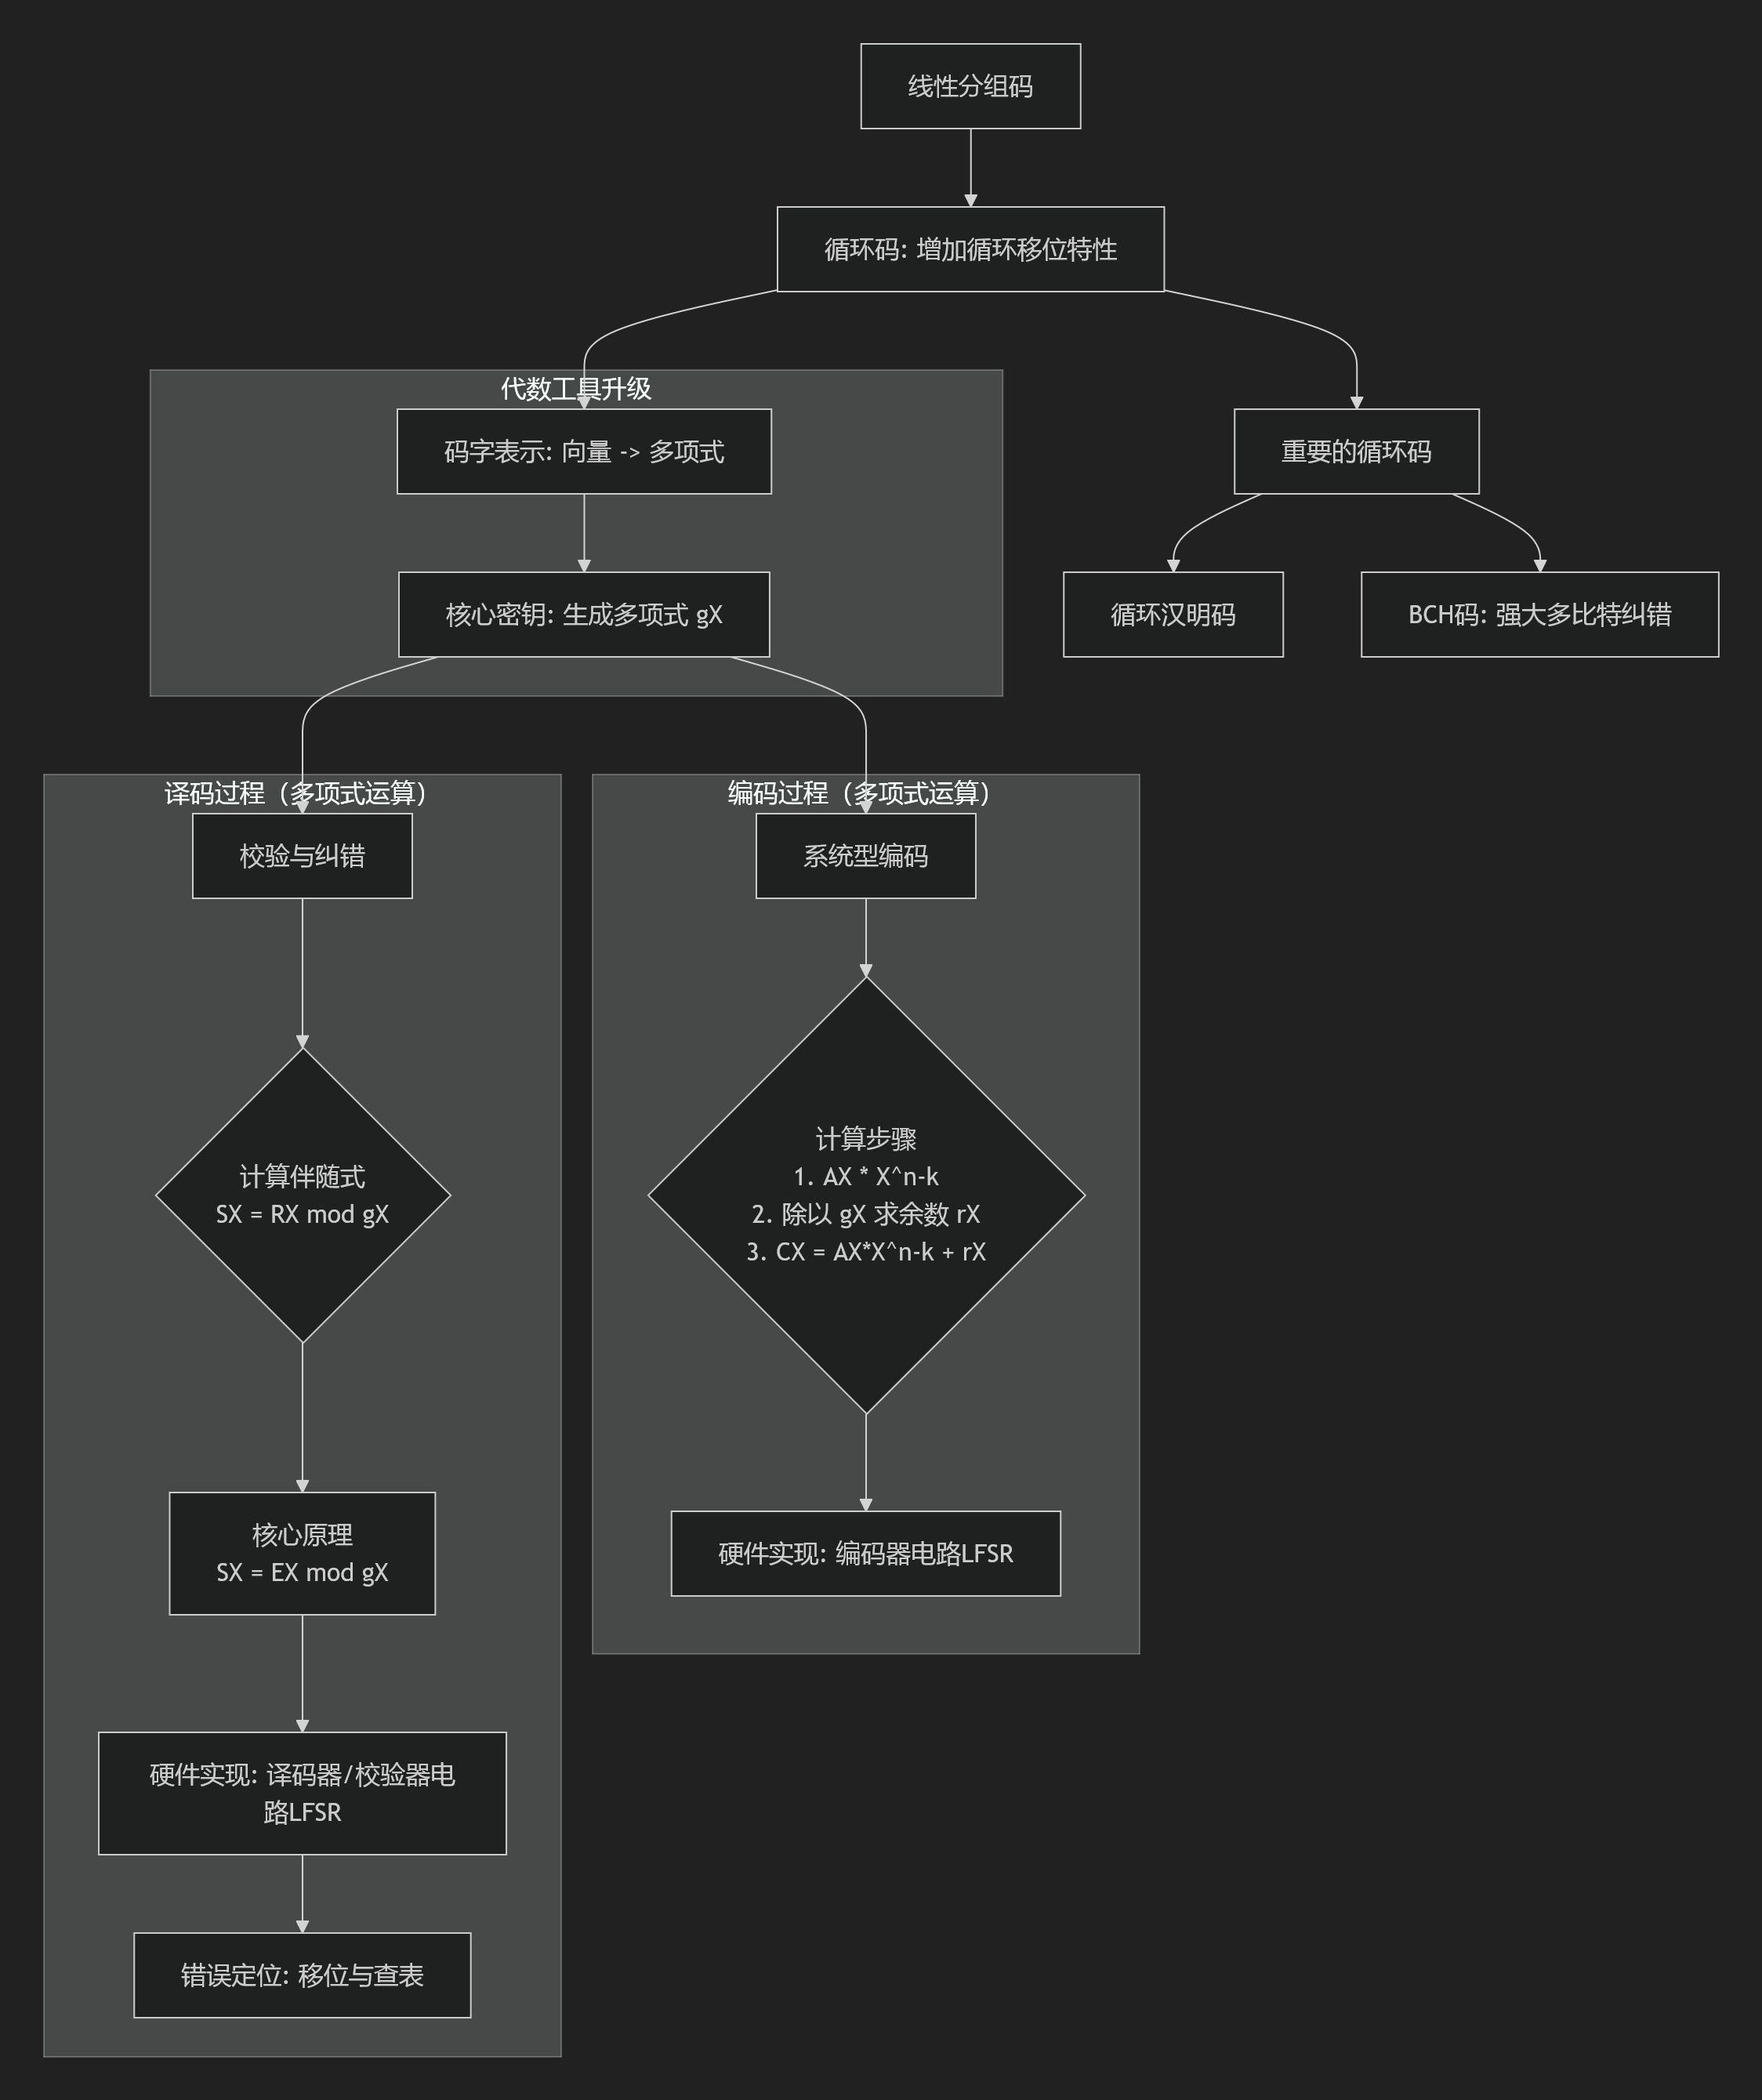
📝 本讲主要内容 #
1. 循环码的新语言:多项式及其运算 #
线性分组码使用向量和矩阵,而循环码则升级到了一个更强大的代数工具:多项式。
1.1. 从向量到多项式 #
一个n维码字 $C = (c_{n-1}, c_{n-2}, \dots, c_1, c_0)$ 可以唯一地表示为一个次数最高为 $n-1$ 的多项式: $$ C(X) = c_{n-1}X^{n-1} + c_{n-2}X^{n-2} + \dots + c_1X^1 + c_0X^0 $$
- 示例 (PPT p115): 码字
[1 1 0 1]$\leftrightarrow$ $C(X) = X^3 + X^2 + 1$。
1.2. 核心运算:GF(2)上的多项式运算 #
所有系数的运算都在 GF(2) 域上进行,即"模2加(异或)“和"模2乘(与)"。
- 加法 (异或)
- 示例:
[1101]+[0101] - $(X^3+X^2+1) + (X^2+1) = X^3 + (1+1)X^2 + (1+1) = X^3$
- 结果:
[1000] - 乘法
- 按普通多项式乘法展开,然后系数模2。
- 示例: $(X^3+X^2+1) \times (X^2+1) = X^5+X^4+X^2+X^3+X^2+1 = X^5+X^4+X^3+1$
- 除法 (模运算)
- 这是循环码的核心运算,使用长除法,但借位时用异或。
- 示例 (PPT p114): $\frac{X^5+X^4+X^3+1}{X^3+X^2+1}$
【图片:PPT p114中的多项式长除法过程图】
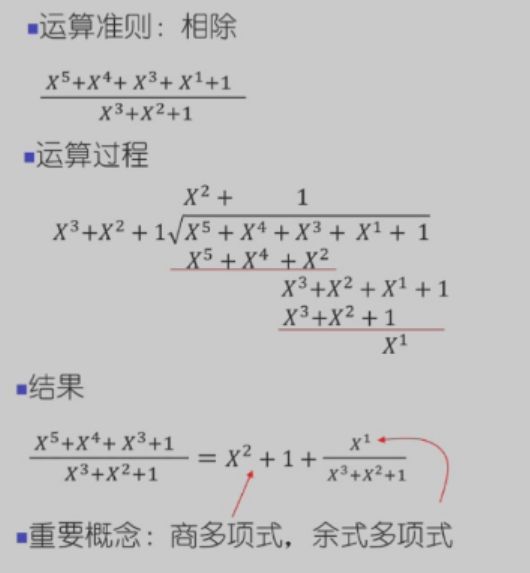 商为 $X^2+1$,余数为 $X^1$。
1.3. 循环码的代数定义 #
- 定义 8.7.1: 一个线性分组码是循环码,如果其码字集 {C} 中任意一个码字 $C$ 循环移位后,得到的码字 $C'$ 仍属于 {C}。
- 代数等价: 码字循环左移一位,在多项式上等价于:$C'(X) = [X \cdot C(X)] \pmod{X^n+1}$。
循环左移可以看作卷积
2. 生成多项式 g(X):循环码的DNA #
- 定理 8.7.4 & 8.7.6:
- 在一个 (n,k) 循环码中,有且仅有一个次数为 $r=n-k$ 的生成多项式 g(X)。
- 任何一个许用码字多项式 C(X) 都能被 g(X) 整除。
- g(X) 必须是 $X^n+1$ 的一个因式。
3. 编码实现:从数学到电路 #
3.1. 系统型循环码编码原理 #
我们重点学习更实用的系统码编码方式。目标是生成 $C(X)$,使其既包含原始信息 $A(X)$,又能被 $g(X)$ 整除。
- 系统码编码步骤 (PPT p126):
-
- 预留监督位:将 k 位信息多项式 $A(X)$ 乘以 $X^{n-k}$,相当于在其末尾添加 $n-k$ 个0,为监督位腾出空间。
-
- 计算监督位:用生成多项式 $g(X)$去除 $X^{n-k}A(X)$,得到余数多项式 $r(X)$。 $$ \frac{X^{n-k}A(X)}{g(X)} = Q(X) + \frac{r(X)}{g(X)} $$
-
- 合成码字:最终的码字多项式 $C_s(X)$ 由预留了位置的信息位和监督位(余数)构成。 $$ C_s(X) = X^{n-k}A(X) + r(X) $$ 这个 $C_s(X)$ 一定能被 $g(X)$ 整除,是一个合法的许用码字。
3.2. 【深度例题剖析】(7,4)系统循环码编码 (PPT p127) #
- 参数: n=7, k=4。生成多项式 $g(X) = X^3+X^2+1$。
- 输入信息:
1100,对应信息多项式 $A(X) = X^3+X^2$。 - 步骤1: 计算 $X^{n-k}A(X) = X^3(X^3+X^2) = X^6+X^5$。
- 步骤2: 做多项式长除法 $\frac{X^6+X^5}{X^3+X^2+1}$。
X^3 + 1 (商 Q(X))
____________
X^3+X^2+1 | X^6 + X^5 + 0 + 0 + 0 + 0
           -(X^6 + X^5 + X^3)
            _________________
            X^3 + 0 + 0 -(X^3 + X^2 + 1)
                ______________
                X^2 + 1 (余数 r(X))
- 步骤3: 合成码字 $C_s(X) = (X^6+X^5) + (X^2+1) = X^6+X^5+X^2+1$。
码字:
[1 1 0 0 1 0 1],其中1100是信息部分,101是监督部分。
3.3. 编码器硬件实现 (PPT p137) #
✨ 费曼学习法之生动比喻:自动余数计算器
- 想象一个有
r个格子的盒子(移位寄存器),每个格子能存一个比特。 - 盒子上有一些"管道”(反馈线),管道的开关位置由
g(X)决定。 - 前 k 步:你把 k 个信息比特一个接一个地从"入口"推进盒子。每推进一个,盒子里的比特就自动"晃动"一次(移位和反馈异或)。这k次推进和晃动,就是在模拟多项式除法。同时,这 k 个比特也直接从"主出口"出去了。
- 后 r 步:你关掉入口,盒子不再晃动,只让里面的比特从"次出口"一个接一个地排队出去。这时出去的,就是你千辛万苦算出来的余数!
电路分析 (PPT p137):
【图片:PPT p137 系统码编码器电路图】
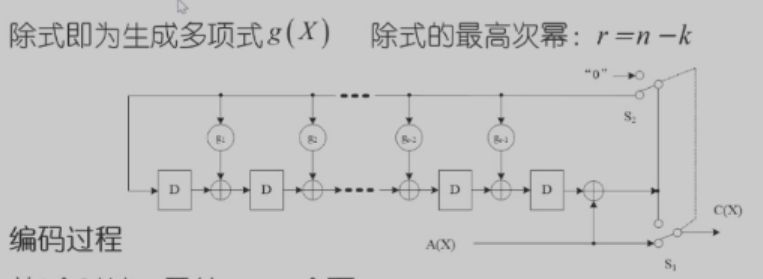
- 电路结构:
- $r=n-k$ 个 D 触发器构成移位寄存器。
- 反馈由加法器(异或门)实现,反馈抽头的位置由 $g(X)$ 的系数决定。$g(X) = X^r + g_{r-1}X^{r-1} + \dots + g_1X + 1$。
- 工作流程:
- 前 k 个时钟: 开关 S1, S2 合下。信息位 $a_{k-1}, \dots, a_0$ 依次输入。
- 信息位直接输出,构成码字 $c_{n-1}, \dots, c_{n-k}$。
- 同时信息位进入除法电路进行运算。
- 后 n-k 个时钟: 开关 S1, S2 合上。
- 输入接地(0),反馈回路断开。
- 寄存器中存储的余数 $r_{n-k-1}, \dots, r_0$ 依次移位输出,构成码字 $c_{n-k-1}, \dots, c_0$。
4. 译码实现:定位错误的艺术 #
4.1. 伴随式 S(X) #
译码过程与线性分组码思想一致,但工具换成了多项式。
- 译码原理 (PPT p138-139):
- 接收多项式 $R(X) = C(X) + E(X)$。
- 伴随式多项式 S(X):计算接收多项式 $R(X)$ 除以 $g(X)$ 的余数。 $$ S(X) = R(X) \pmod{g(X)} $$
- 核心性质: 由于 $C(X)$ 一定能被 $g(X)$ 整除,所以 $C(X) \pmod{g(X)} = 0$。 因此: $$ S(X) = [C(X) + E(X)] \pmod{g(X)} = E(X) \pmod{g(X)} $$ 伴随式 S(X) 只取决于错误图样 E(X)!
4.2. 译码器硬件实现 (PPT p140) #
译码器的核心就是一个伴随式计算电路,它和编码器中的除法电路结构完全相同。
【图片:PPT p140 的 (7,4) 循环码译码电路图,g(X) = X^3+X^2+1】
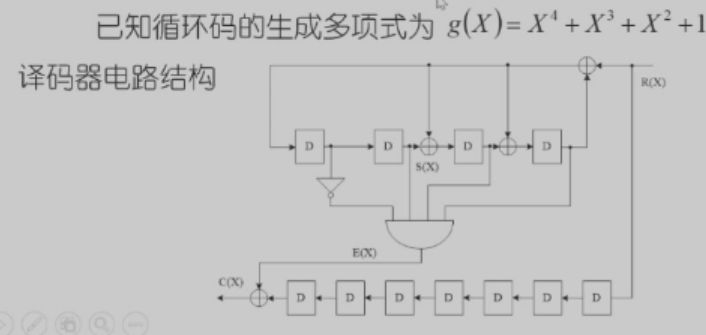
- 电路工作:
- 将接收到的 n 位码字 R 串行输入到该电路。
- 当 n 位全部输入完毕后,寄存器中的
r位值就是伴随式 S。 - 如果 S 全为 0,则判定无错误。
4.3. 【核心】错误定位的电路技巧 (Meggit译码器思想, PPT p139, 141) #
如果S不为0,如何找到错误位置 E 呢?
- 理论基础: 错误图样和伴随式之间存在循环关系。
- 如果错误是 $E(X)$,伴随式是 $S(X)$。
- 如果将错误循环移一位变成 $E_1(X) = X \cdot E(X) \pmod{X^n+1}$,那么新的伴随式 $S_1(X) = [X \cdot S(X)] \pmod{g(X)}$。
- 这意味着,对伴随式进行一次移位寄存器操作,得到的就是移位后错误图样的新伴随式!
- 译码过程详解:
- 计算初始伴随式: 接收的 n 位码字
R通过伴随式电路,得到初始伴随式S。 - 循环移位寻找"靶心":
- 我们预先设定一个"靶心",即一个特定的错误模式,通常是最高位出错,即 $E_{target}(X) = X^{n-1}$。我们计算出它的伴随式 $S_{target}$。
- 然后,我们继续向伴随式电路输入
0,并让它继续工作。每输入一个0,寄存器中的伴随式就会更新一次,这个过程就模拟了错误位置在不断地"循环移位"。 - 我们用一个逻辑电路持续检测寄存器中的值,看它是否等于我们预设的 $S_{target}$。
- 执行纠错:
- 假设经过
i次移位后,寄存器中的伴随式恰好等于 $S_{target}$。 - 这说明,原始的错误位置,经过
i次循环移位后,跑到了最高位。反过来说,原始错误就在第 n-i 位! - 为了纠正它,我们让接收码字
R在一个同样长为 n 的缓冲寄存器里同步移位。当伴随式等于 $S_{target}$ 时,缓冲寄存器出口处的比特正好就是那个出错的比特,我们用一个异或门将其翻转即可。
- 假设经过
- 计算初始伴随式: 接收的 n 位码字
- 示例 (PPT p141): 对于一个(7,4)码,假设我们把第1位($X^0$)出错的伴随式
001作为"靶心"。- 如果收到的伴随式是
111(第2位出错),我们让电路继续移位。 - 移1次,
111变为011(第3位出错的伴随式)。 - 移2次,
011变为110(第4位出错的伴随式)。 - …
- 移6次后,伴随式会变为
001,与"靶心"匹配!此时我们知道错误在第 $7-6=1$ 位,即第1位。 - 结论: 译码器硬件不需要存储整个查找表,只需要一个固定的"靶心"比较器和一个计数器(或同步的缓冲器)即可完成纠错,极大简化了电路。
- 如果收到的伴随式是
5. 循环码家族:汉明码与BCH码 #
- 循环汉明码 (PPT p142)
- 当(n,k)参数满足 $n=2^m-1, k=n-m$,且生成多项式 g(X) 是一个 m 次的本原多项式时,得到的循环码就是汉明码。
- 它继承了汉明码 $d_{min}=3$ 的特性,是高效的单比特纠错码。
- PPT p143的表格给出了不同m值可构造的循环汉明码参数。
- BCH码 (PPT p146)
- ✨ 费曼学习法之生动比喻:带多把"尺子"的校验系统
- 普通循环码用一把尺子
g(X)去测量。 - BCH码非常"严格",它要求一个合法的码字必须同时被多把特定的尺子($m_1(X), m_2(X), \dots$)整除。它的生成多项式
g(X)是这些尺子的"最小公倍多项式"。 - 这些"尺子"的选择,是基于高阶有限域(伽罗华域)$GF(2^m)$ 中的元素(根)来确定的。
- 普通循环码用一把尺子
- 能力: BCH码的设计非常灵活,可以通过选择
g(X)的根,精确地构造出能纠正任意 t 个错误的码。 - 参数 (PPT p149, 155):
- 码长 $n=2^m-1$。
- 最小码距 $d_{min} \ge 2t+1$ (由设计保证)。
- 监督位数 $r=n-k \le mt$。
- PPT p155的表格展示了BCH码的强大能力,例如一个(63, 24)的BCH码可以纠正多达7个错误!
- ✨ 费曼学习法之生动比喻:带多把"尺子"的校验系统
🔗 知识关联与应用 #
- 承上启下:循环码是线性分组码的一个子集,但它引入了多项式和代数域的工具,使得分析和实现(特别是硬件实现)都大大简化。它是通往更高级的BCH码和里德-所罗门码(RS码)的桥梁。
- 现实应用:
-
- CRC (循环冗余校验): 这是循环码最广为人知的应用。以太网帧、Wi-Fi数据包、SATA/USB数据传输、ZIP/RAR压缩文件,几乎所有需要数据完整性校验的地方,都在使用CRC。它本质上就是一个只检错不纠错的循环码系统,其校验器电路就是我们今天学习的除法电路。
-
- 里德-所罗门 (RS) 码: 这是一种在更高阶有限域上构造的非二元BCH码。它对于突发错误(连续一片数据出错)有极强的纠正能力,广泛应用于CD/DVD/蓝光光盘、二维码、数字电视广播等领域。
-
🤔 引导式提问 #
- 为什么生成多项式 g(X) 必须是 X^n+1 的一个因式?这与码字的"循环"特性之间究竟有什么数学联系? (提示:思考码字循环移位一位,在多项式上等效于乘以X再模 $X^n+1$)
- 对比线性分组码的矩阵译码(计算S=RHᵀ, 查表)和循环码的电路译码(LFSR计算S(X),移位纠错),两者在实现复杂度、译码速度和所需存储(查找表大小)方面各有什么优缺点?
- CRC只能检错,而BCH码能纠错。从生成多项式 g(X) 的角度看,你认为是什么核心差异导致了它们能力的不同?(提示:g(X)的根在哪个域上,以及根的性质)
💡 本讲总结 #
今天我们完成了一次从理论到实践的华丽飞跃。循环码的核心魅力在于它将复杂的纠错问题代数化和电路化了。我们用多项式作为语言,以生成多项式g(X)为"基因",通过多项式除法实现了系统化的编码。更精彩的是译码部分,我们揭示了伴随式S(X)和错误E(X)之间的深刻联系,并理解了如何利用伴随式的循环特性,设计出无需庞大查找表、仅靠移位和比较就能完成错误定位的高效译码电路。最后,通过了解BCH码等高级循环码,我们看到了这条技术路线的巨大潜力。可以说,掌握了循环码,你就掌握了现代数字通信和存储系统中差错控制的半壁江山。
