
大模型 (Large Language Model) #
一句话
大模型是经过海量数据训练出来的AI,能理解和生成自然语言。ChatGPT、Claude、Gemini 背后跑的都是大模型。
1. 它不是什么 #
先破几个误解:
- 不是搜索引擎 — 它不是去查资料,而是根据学到的知识"生成"回答。所以会幻觉(一本正经编造内容)
- 不是数据库 — 每次对话是独立的(除非有记忆功能或上下文窗口)
- 不是通用智能 — 训练数据覆盖的领域很强,没见过的领域会瞎编
- 不等于AI本身 — 大模型(LLM)只是 AI 的一个子集。传统的机器视觉、推荐系统、语音识别等依然活跃,只是它们嵌入在产品里,用户感知不到。这篇笔记(和整个文件夹)主要讲 LLM,因为这是当前最实用、接触最多的部分
关于幻觉
AI降智的时候会乱编东西——而且编得特别自信。我的应对方式:靠认知和感觉觉得不对劲时,把这段内容发给另一个AI让它审查。因为你不确定当前模型是否降智了,换一个模型交叉验证最安全。
2. 关键参数 #
| 参数 | 说明 | 你需要关心吗 |
|---|---|---|
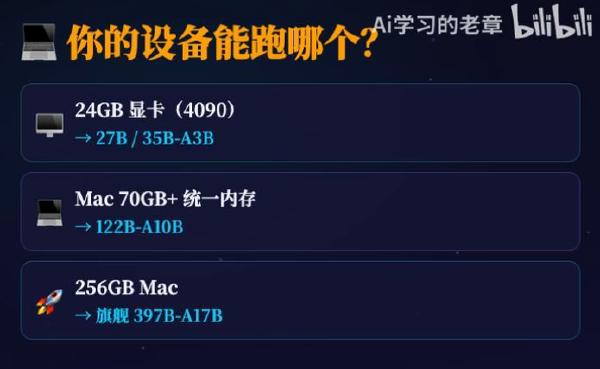
| 参数量(B = 十亿) | 模型有多少可调节的"旋钮" | 越大通常越聪明,但越吃资源 |
| 上下文窗口 | 一次对话能处理多少文字 | 32k ≈ 约2万中文字,128k ≈ 约8万中文字 |
| 温度 (Temperature) | 输出的随机性 | 回答太死板→拉高;太发散→拉低。别极端 |
| Top-P | 候选词采样范围 | 和温度类似,控制多样性 |
3. 模型怎么选 #
不用纠结"哪个最好"。大厂的旗舰模型差距在缩小,关键看几点:
- 能不能访问 — 国内直连:DeepSeek、通义千问、Trae内置。需代理:ChatGPT、Claude、Gemini
- 使用场景 — 写代码选Claude/GPT,多模态(图+文)选Gemini,省钱选DeepSeek
- 上下文长度 — 要分析长文档/整个代码库,选上下文窗口大的
- 使用方式 — 官网对话 vs API接入 vs 本地部署
提示
GPT和Claude都是目前的顶尖模型,根据个人喜好选即可。想要回答更像活人→Claude;综合能力和逻辑→GPT;代码→目前Claude很强。注意:Claude国内访问限制比GPT更严,可能封号,价格也更贵。
怎么判断"这个模型不对劲" #
用着用着你会发现有些时候模型就是不好使。我的判断方式:
- 输出达不到预期 — 反复理解错你的意思
- 看思维链 — 如果模型有思维链输出,看它的推理过程是不是跑偏了
- 根据经验换模型 — 确认是模型的问题而不是提示词的问题,就换一个试试
我的经验
有时候不是你说的不清楚,就是这个模型在这个任务上不行。比如 Gemini 做前端设计就是比 GPT 到位,硬让 GPT 做可能折腾半天。不如换一个。
模型的"个性" #
不同模型确实有不同的"性格":
- GPT — 回答风格比较…GPT?喜欢用"不是…而是…"、“稳稳地接住你"这种句式,结构化强但有时候读起来像模板
- Claude — 更像活人一些,语气更自然,代码能力目前很强
- Gemini — 对前端和设计理解到位,多模态能力强
这不是说哪个好哪个差——是风格差异。你用久了自然会有偏好。
4. 对话太长了怎么办 #
上下文窗口不是无限的。对话太长,AI会开始"忘事"或者前后矛盾。
我的处理方式
- IDE里写代码 — 一般自带对话压缩功能,不用手动操作
- 网页端闲聊/角色扮演 — 要手动处理:让当前AI总结对话 → 或者导出给专门的AI窗口总结 → 把总结导入新窗口
其实上下文继承的原理和角色扮演的原理一致:你给AI的所有文字就是它的全部"记忆”,总结 = 压缩记忆,新窗口 + 总结 = 带着记忆重生。详见 如何让AI按照自定义人设。
5. “人类知识的平均值” #
我的感受
AI给出的回答通常是"正确的",但缺乏那种很惊艳的发散性创新。它更像一个涉猎广泛的通才,而不是某个领域的顶尖专家。越是你了解的领域,越容易看出它的局限。 GPT的PRO模式听说发散挺强的,但是我没有会员,没试过。
6. 大模型 vs 工具 #
大模型是"大脑",工具是"壳":
- Claude(大模型)→ Claude Code(工具)
- GPT-5.4(大模型)→ GitHub Copilot(工具)
- Gemini(大模型)→ Google AI Studio、Antigravity(工具)
同一个大模型可以被不同的工具调用。工具决定了你怎么用它(聊天窗口 vs 代码编辑器 vs 终端)。
关联 #
- API — 怎么让代码直接调用大模型
- 训练 — 大模型是怎么学会的
- 推理 — 大模型是怎么回答问题的
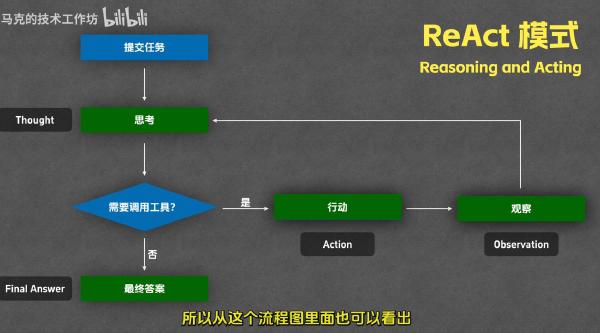
- AI Agent与MCP — 大模型 + 工具调用 = Agent