
AI 本地部署 #
一句话
把AI模型下载到自己电脑上跑。好处是免费、隐私好、不需要联网。坏处是需要好显卡,而且本地小模型和云端大模型的质量差距明显。
1. 为什么要本地部署 #
我的动机
那段时间本地部署很火,自己也有隐私笔记做QA问答的需求——不想把私人笔记发到云端。另外纯粹好奇也占一部分。
2. 核心概念 #
本地部署 = 本地推理。你下载一个模型文件(GGUF格式居多),用推理引擎加载它,然后就可以在本地对话了。
3. 工具链 #
底层:推理引擎 #
| 工具 | 说明 | 适合谁 |
|---|---|---|
| llama.cpp | C++写的推理引擎,所有上层工具的基础 | 想深入研究的人 |
| Ollama | 把llama.cpp包装成一行命令就能跑 | 大多数人的首选 |
Ollama 真的很简单
第一次跑的时候感觉就是——其实一行命令就行。ollama run qwen2.5:8b 就开始对话了。虽然方便,但要研究还是直接用 llama.cpp,能理解底层发生了什么。
上层:图形界面 #
| 工具 | 说明 |
|---|---|
| LM Studio | 桌面应用,图形界面,下载模型 + 对话一体化 |
| Open WebUI | Web界面,功能最全,支持多用户 |
| Cherry Studio | 桌面端多模型聚合客户端 |
模型来源 #
- Hugging Face — 模型的 GitHub,大部分开源模型都在这里下载
- GGUF 格式 — llama.cpp 系列用的模型格式,量化后的文件
- 量化版本 — 详见推理#3.量化(Quantization)
4. 硬件门槛 #
实话
消费显卡(RTX 5060 级别)能跑 7-8B 的模型,体验和聊天差不多。但和 GPT-5.4、Claude Opus 4.6 这些云端大模型相比,质量差距非常明显。本地模型目前更适合"玩具"和"隐私需求",不适合替代云端模型做正经事。
| 硬件 | 能跑什么 |
|---|---|
| 8GB 显存(5060) | 7B Q4 量化,勉强能用 |
| 12GB 显存(4070/5070) | 13B Q4,体验不错 |
| 24GB 显存(4090/5090) | 30B Q4,或 70B Q2(质量很差) |
| 多卡 / A100 | 70B+ 完整精度 |
| 纯CPU | 能跑,但非常慢(几秒出一个字) |
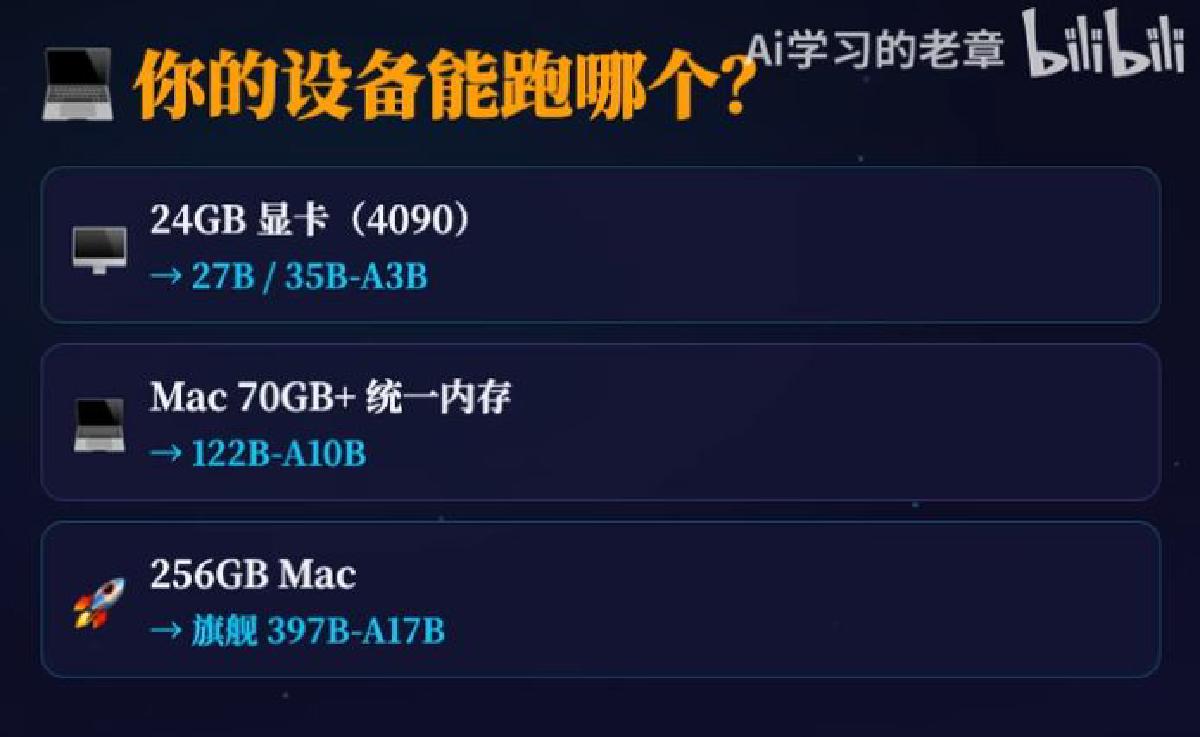
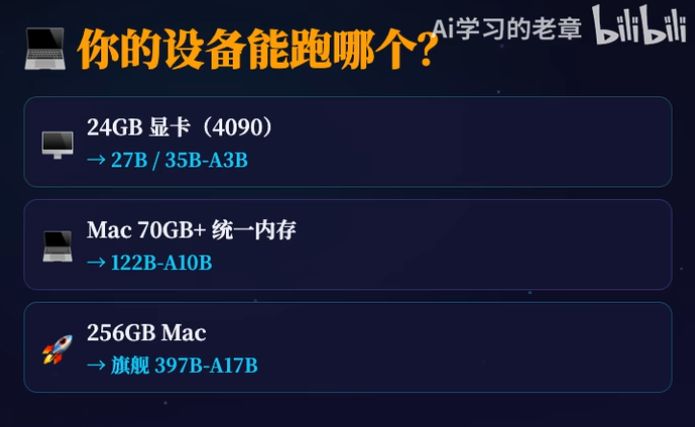
QWEN3.5 35B-A3B,这里A指激活参数,负担会小一点
5. 云平台(租GPU) #
不想买显卡但想跑大模型:
| 平台 | 说明 |
|---|---|
| AutoDL | 国内,便宜,支持支付宝 |
| Vast.ai | 国外,价格最低但不太稳定 |
| RunPod | 国外,界面好 |
| Lambda | 国外,贵但稳定 |
AI给的: 租 A100 40GB 大约 ¥2-5/小时,跑推理够了,训练看模型大小。
6. 我的现状 #
目前怎么用
本地 Ollama 主要用来做两件事:
- Obsidian 仓库检索 — 笔记太多的时候用来做QA问答
- 改改文字 — 简单的文本任务
现在用 IDE 写笔记比较多,本地模型的使用频率没有以前高了。
建议 #
- 想试试什么是本地部署 → 装 Ollama,一行命令跑个 7B 模型
- 想日常使用 → 不如直接用API或官网对话,质量好太多
- 想隐私保护 → 本地跑有意义,数据不出你的电脑
- 想深入理解 → 从 llama.cpp 开始,理解量化、显存、推理速度
模型部署参考 #
涉及云端、本地部署、Anaconda虚拟环境、CUDA、Pytorcha安装
【Qwen3TTS】橘雪莉也能看懂的Qwen3TTS部署教程!】