
训练 (Training) #
一句话
训练是让模型从数据中学习知识和能力的过程。类比:上课学习。
1. 训练的层级 #
预训练 (Pre-training)
  │  用海量互联网数据训练基础能力(语言理解、知识、推理)
  │  成本:数千万到数亿美元,需要数千块GPU
  │  只有大公司做得起(OpenAI、Google、Anthropic、Meta……)
  ↓
微调 (Fine-tuning) / 继续训练
  │  用特定领域数据再训练,让模型更懂某个方向
  │  成本:几百到几万美元,几块GPU就能做
  │  企业和个人都可以做(如果有好显卡或云平台)
  ↓
RLHF / 对齐训练
  │  用人类反馈来调整模型的行为(更安全、更有用、更拒绝有害请求)
  │  这就是为什么模型会说"我不能帮你做那个"
  ↓
提示词工程 (Prompt Engineering)
     不修改模型,只通过改变输入来控制输出
     零成本,所有人都能做
     → 详见 [提示词工程](提示词工程.md)
对大多数人来说
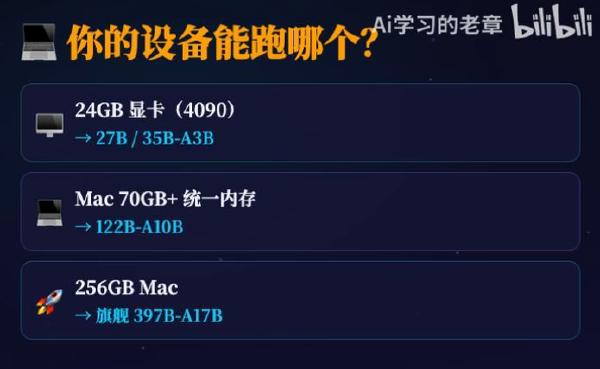
你只需要关心最底层的提示词工程。训练和微调是"大厂的事",除非你有特定需求和硬件。现在大模型的性能已经够用了,大厂模型又都闭源——开源模型本地部署是两难:太大跑不了,太小不够用。
2. 我的训练经历 #
GPT-SoVITS语音克隆
做过一次语音克隆的训练(严格说是基于现有模型的继续训练)。当时纯粹是觉得好玩。
过程本身不难——有官方文档,一步步教。坑在细节上:
- 数据集:收集、整理、处理语音数据占了大部分时间
- 训练参数:没配好直接爆显存。参数调小了质量又不行
- 硬件:需要显卡,消费级的勉强够
3. 微调 vs RAG #
两种让AI"更懂你"的方式,解决不同问题:
| 微调 (Fine-tuning) | RAG (检索增强生成) | |
|---|---|---|
| 类比 | 给通才请私教,专攻一科 | 给AI一本参考书,让它翻书回答 |
| 怎么做 | 用你的数据重新训练模型的部分参数 | 把你的文档建成索引,AI检索后回答 |
| 改了什么 | 模型本身变了 | 模型没变,只是给了额外资料 |
| 成本 | 需要显卡/云平台,需要训练数据 | 相对便宜,只需要文档和向量数据库 |
| 适合 | 让模型学会特定风格/领域知识 | 让模型回答基于你的私有文档 |
| 例子 | 训练一个会写你风格代码的模型 | 让AI基于你的笔记库回答问题 |
Obsidian Copilot RAG
把笔记建成索引,AI检索后回答。不过因为我用的是本地部署的 Ollama 小模型,功能上比不过云端大模型——目前主要用来查看相关笔记和知识库检索问答,让它做逻辑思考就力不从心了。
4. 训练 vs 推理 #
| 训练 | 推理 | |
|---|---|---|
| 类比 | 上课学习 | 考试答题 |
| 做什么 | 从数据中学习 | 用学过的知识回答问题 |
| 资源需求 | 极高(大量GPU、长时间) | 相对低(消费显卡可以跑小模型) |
| 谁做 | 大公司、研究者 | 所有人(通过API或本地部署) |
5. 硬件门槛 #
- 消费卡(如RTX 5060/5070)→ 只够做小模型的小规模微调(LoRA等),或者像我一样训个语音克隆
- 云平台(如AutoDL、Vast.ai)→ 租GPU做训练,按小时收费
- 本地训练→ 对大多数人来说不现实,除非有A100/H100级别的卡