
推理 (Inference) #
一句话
推理是用训练好的模型来回答问题的过程。类比:考试答题(用学过的知识作答)。
1. 怎么理解 #
每次你在ChatGPT里打字问问题,后台发生的就是推理:
你的输入(prompt)→ 模型处理(推理)→ 生成回答
推理不改变模型本身,只是"用"模型。就像翻开一本已经写好的教科书去做题。
2. 推理的硬件要求 #
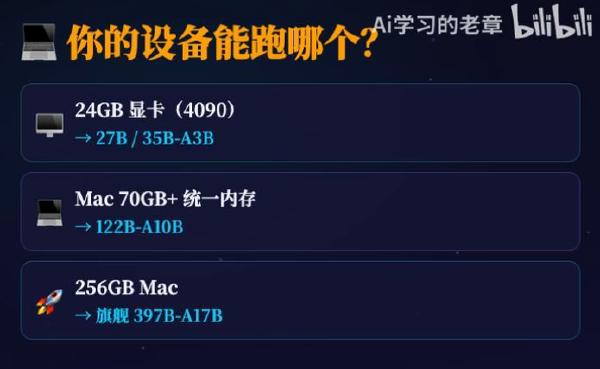
推理比训练轻得多,这也是为什么普通人可以在自己电脑上跑模型。
模型大小 → 显存需求 #
| 模型大小 | 显存需求(大致) | 能跑的卡 |
|---|---|---|
| 1-3B(小模型) | ~2-4GB | 任何现代显卡 |
| 7-8B | ~6-8GB | RTX 3060/4060/5060 |
| 13-14B | ~10-14GB | RTX 3090/4080/5070Ti |
| 30-34B | ~20-24GB | RTX 3090/4090 |
| 70B | ~40GB+ | 消费卡跑不了,需要多卡或A100 |
我的实际体验(RTX 4060)
- Qwen2.5 4B/8B — 还行,日常能用
- DeepSeek-R1 14B — 慢,但能跑
- Qwen3 Embedding 4B — 很慢,但效果好(做向量检索用)
- Embedding Gemma 300M — 快(嵌入模型本来就小)
基本规律:参数越大越慢,但效果越好。4060 跑 8B 以下比较舒服,14B 开始吃力。嵌入模型另外说。
3. 量化 (Quantization) #
把模型精度降低来减少显存占用。类比:把高清照片压缩成中等画质——体积小了很多,但质量还能接受。
| 精度 | 说明 | 显存占用 |
|---|---|---|
| FP16 | 原始精度,效果最好 | 最大 |
| Q8(8-bit) | 质量损失很小 | 约减半 |
| Q4(4-bit) | 开始有明显质量损失 | 再减半 |
| Q2 | 效果明显变差 | 最小 |
现实情况
我只用过量化后的 LLM——全量根本跑不动。消费卡基本就是量化或者不用的区别。大部分本地玩家用 Q4 或 Q5,是显存和质量的平衡点。
4. 在线推理 vs 本地推理 #
| 在线推理(API/网页) | 本地推理 | |
|---|---|---|
| 硬件 | 不需要好显卡 | 需要好显卡(至少6-8GB显存) |
| 费用 | 按token付费或订阅 | 免费(电费除外) |
| 隐私 | 数据发送到服务商 | 数据不出本地 |
| 模型选择 | 可以用最强的模型 | 受限于你的硬件 |
| 速度 | 取决于网络和服务商负载 | 取决于你的硬件 |
我的选择
日常主要用在线推理——云端大模型效果更好。需求不高、或者隐私要求高的时候才切到本地。本地模型的定位更像是"随身备用"而不是"主力"。
5. 推理速度指标 #
- tokens/s:每秒生成多少token。日常对话需要 ~10-20 tokens/s 才不会觉得慢
- 首token延迟:发出问题到开始回答的等待时间